Data Privacy and Anonymization in Python
Rebeca Gonzalez
Data engineer
from diffprivlib.models import KMeans


# 以 DP 模型計算叢集
model = KMeans(epsilon=1, n_clusters=3)


# 執行模型並取得叢集
clusters = model.fit_predict(X)
from diffprivlib.models import KMeans
# 以 DP 模型計算叢集 model = KMeans(epsilon=1, n_clusters=3)
# 執行模型並取得叢集 clusters = model.fit_predict(X)
StandardScaler
diffprivlib
sklearn
from sklearn.decomposition import PCA


# 初始化 PCA
pca = PCA()


# 以 PCA 擬合並轉換資料
X = pca.fit_transform(X)


# 以 DP 模型計算叢集
model = dp_Kmeans(epsilon=1, n_clusters=3)


# 執行模型並取得叢集
clusters = model.fit_predict(X)
from sklearn.decomposition import PCA
# 初始化 PCA pca = PCA()
# 以 PCA 擬合並轉換資料 X = pca.fit_transform(X)
# 以 DP 模型計算叢集 model = dp_Kmeans(epsilon=1, n_clusters=3)
from diffprivlib.models import KMeans as model


# 以 DP 模型計算叢集
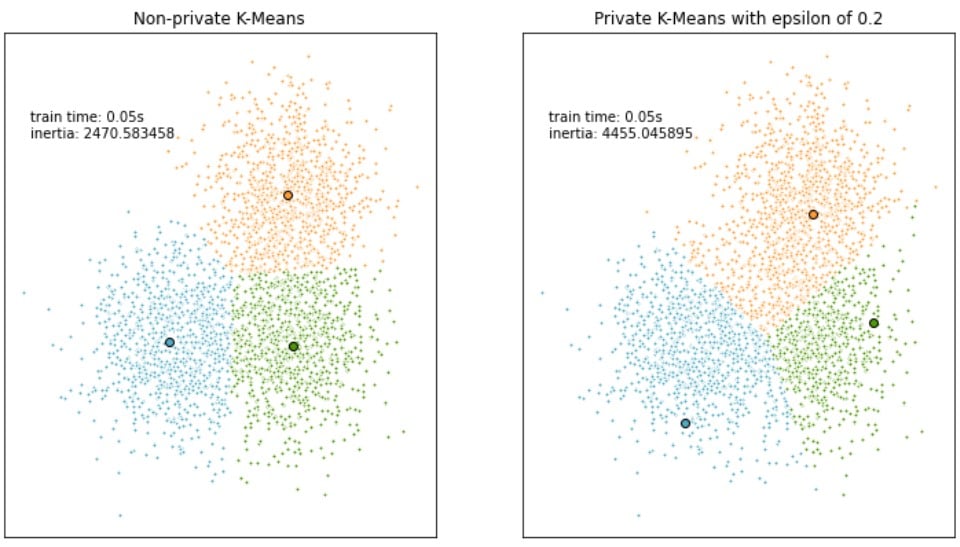
model = dp_Kmeans(epsilon=0.2, n_clusters=3)


# 執行模型並取得叢集
clusters = model.fit_predict(X)
from diffprivlib.models import KMeans as model
# 以 DP 模型計算叢集 model = dp_Kmeans(epsilon=0.2, n_clusters=3)