使用 Faker 進行資料遮罩與資料產生

Data Privacy and Anonymization in Python

Rebeca Gonzalez

Data engineer

準識別子

非敏感的可辨識個人資訊也可能是準識別子。 文字為「歐洲政府首腦」與一個生日,並有線條指向 Angela Merkel 的臉
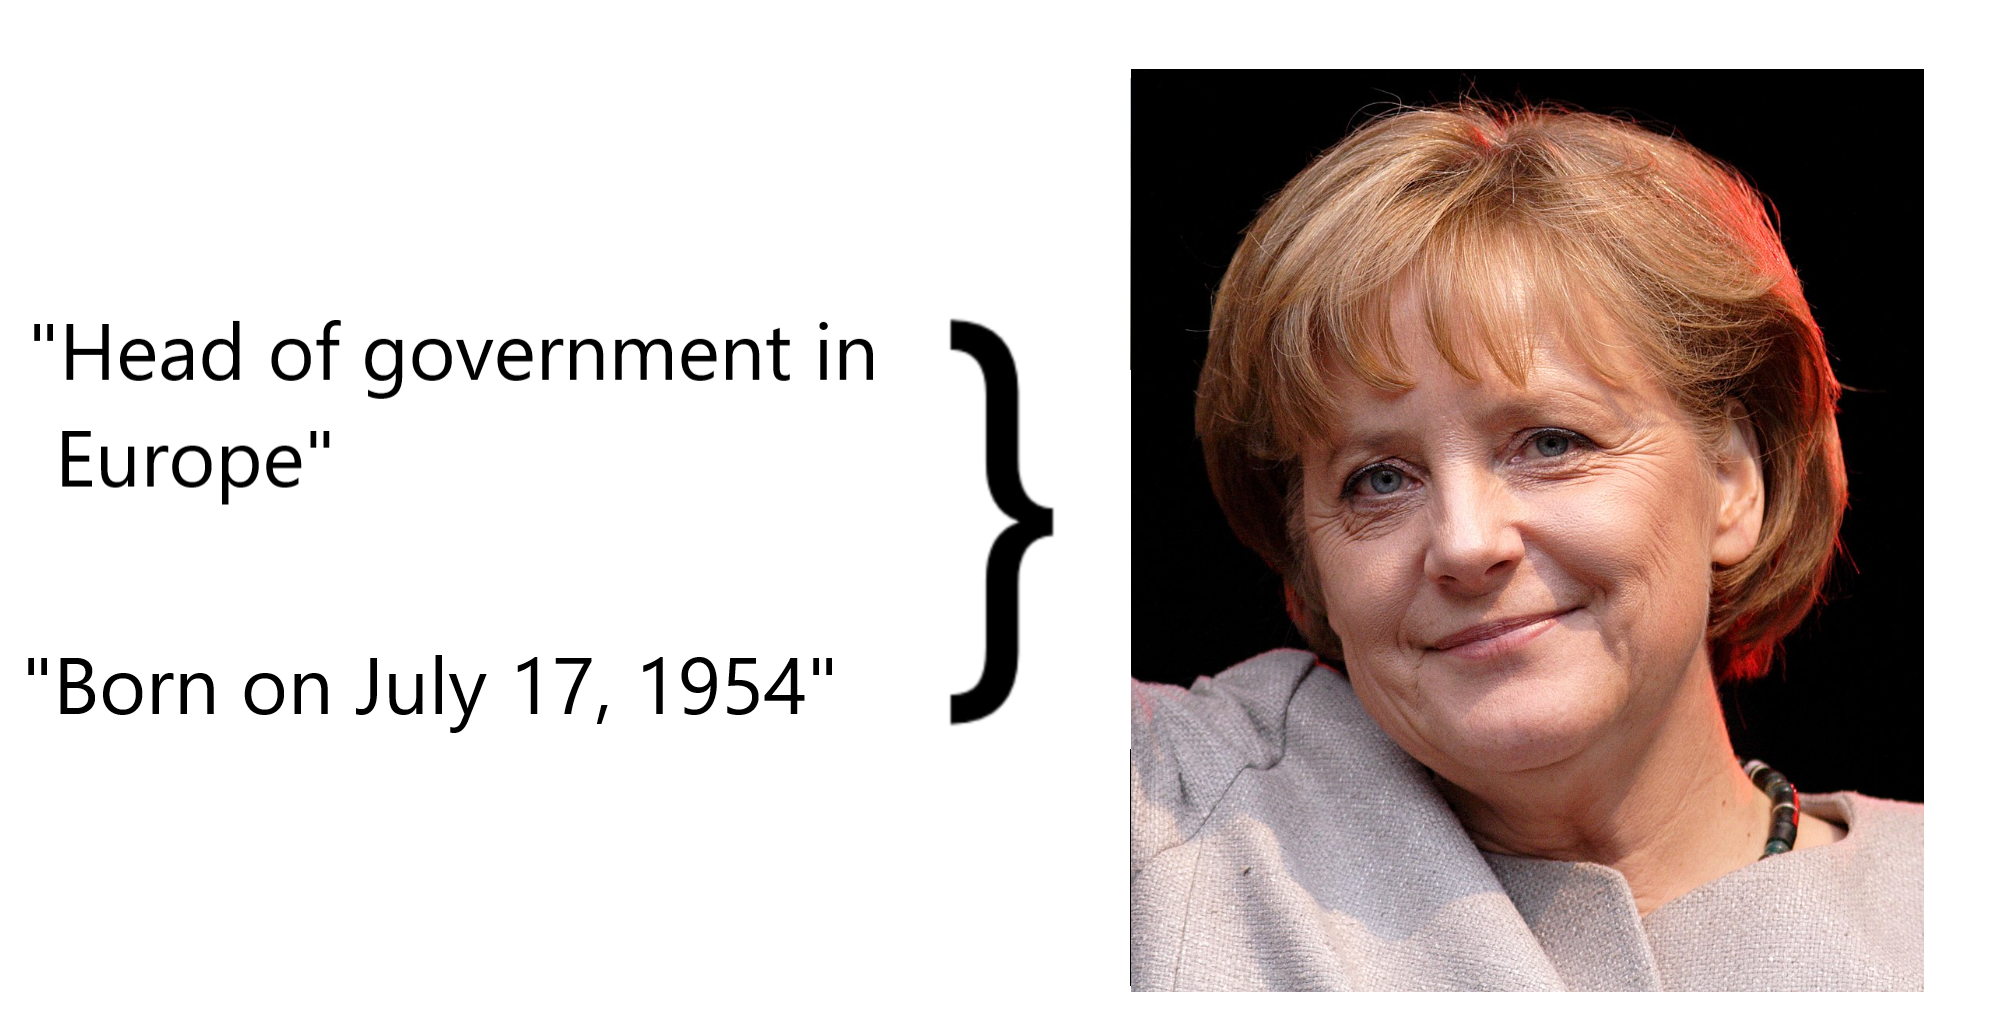
1 Angela Merkel 照片來源:Wikimedia Commons
Data Privacy and Anonymization in Python

準識別子

與其他準識別子結合時,可能足以識別個人。

  • 年齡
  • 性別
  • 職業
  • 個人日期:出生、死亡、就醫、就診等

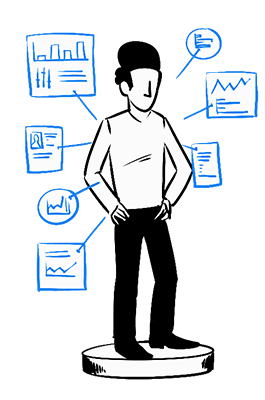
一位男子的插畫,周圍彈出看似個人資訊的視窗

Data Privacy and Anonymization in Python

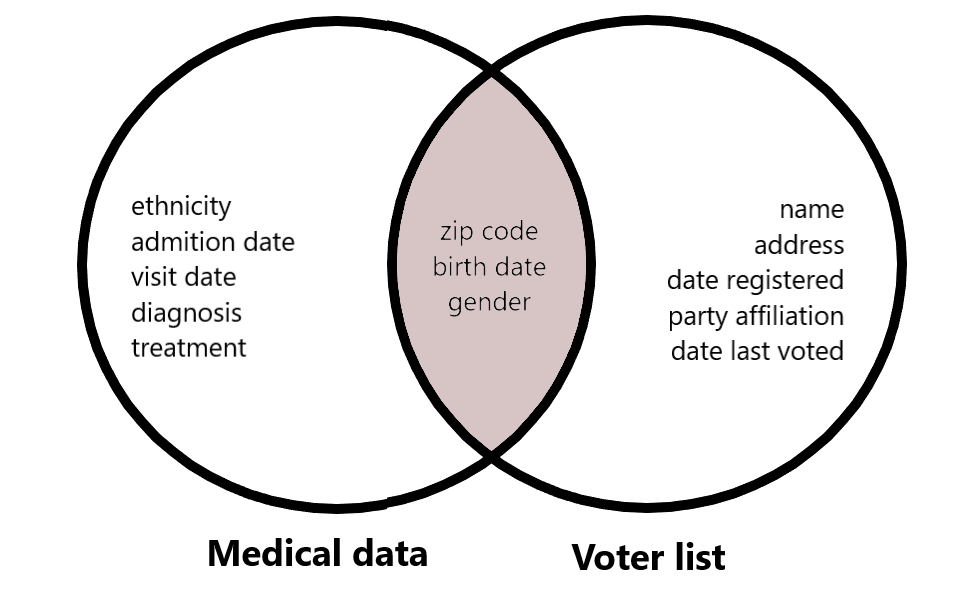
準識別子與再識別攻擊

圖示顯示兩個資料集的交集:醫療資料與選民名冊,其交集為郵遞區號、生日與性別

Data Privacy and Anonymization in Python

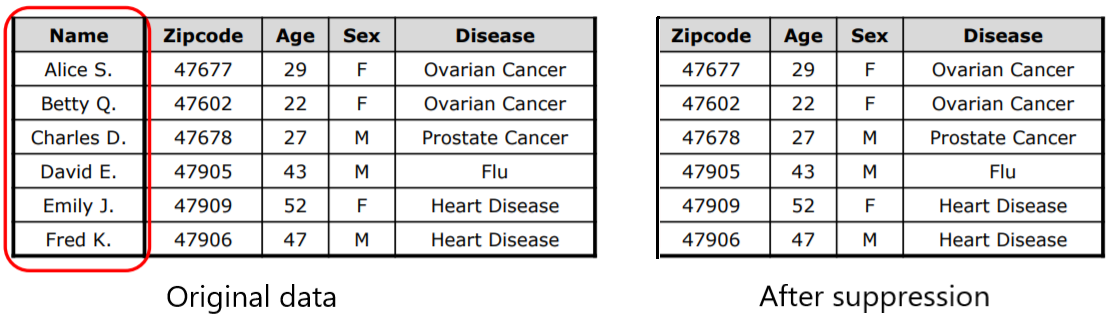
更多匿名化技巧

針對準識別子的匿名化技巧,可降低資料外洩風險。 兩個含醫療與個人資料的表格。左邊為原始資料,右邊為移除姓名欄位後的結果資料集

Data Privacy and Anonymization in Python

資料遮罩(Data masking)

原始 DataFrame

     name                phone
0    Cassandra Nelson    4399406975395
1    Brian Moss          0389407128613
2    Melody Gill         8283308773967
3    Sandra Huber        4366608954250
4    Patricia Webster    4466462475574

名稱已遮罩的 DataFrame

     name    phone
0    xxxx    4399406975395
1    xxxx    0389407128613
2    xxxx    8283308773967
3    xxxx    4366608954250
4    xxxx    4466462475574

以其他字元(如「x」)取代敏感值,稱為資料遮罩。

Data Privacy and Anonymization in Python

資料遮罩(Data masking)

# Explore the DataFrame
df.head()
     country         card_number           email
0    Finland         3546746666030419      [email protected]
1    Belarus         4303032415762821      [email protected]
2    Turkmenistan    4536883671157         [email protected]
3    Puerto Rico     3568819286614160      [email protected]
4    Angola          2514167462583016      [email protected]
Data Privacy and Anonymization in Python

資料遮罩(Data masking)

# Uniformly mask the card number colum 
df['card_number'] = '****'


# See resulting DataFrame df.head()
     country         card_number     email
0    Finland         ****            [email protected]
1    Belarus         ****            [email protected]
2    Turkmenistan    ****            [email protected]
3    Puerto Rico     ****            [email protected]
4    Angola          ****            [email protected]
Data Privacy and Anonymization in Python

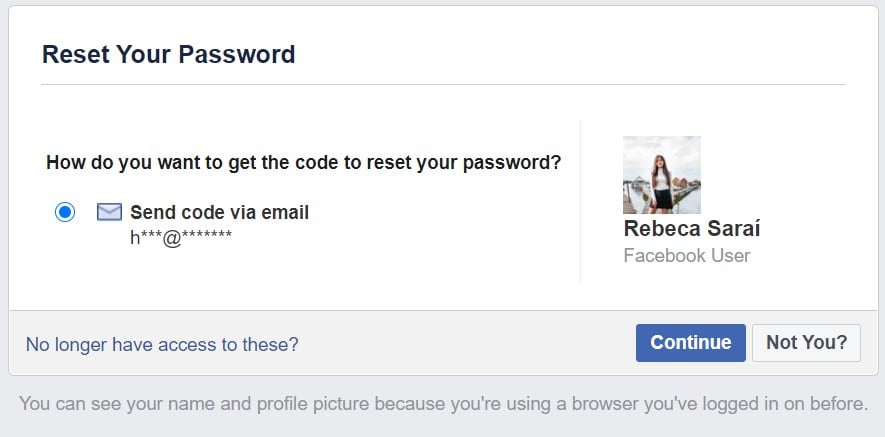
部分資料遮罩

Facebook 重設密碼頁面的截圖,顯示部分遮罩的電子郵件

Data Privacy and Anonymization in Python

部分資料遮罩

# Mask username from email
df2['email'] = df2['email'].apply(lambda s: s[0] + '****' + s[s.find('@'):] )


# See the resulting pseudonymized data df2.head()
     country         card_number           email
0    Finland         3546746666030419      f****@gmail.com
1    Belarus         4303032415762821      m****@gmail.com
2    Turkmenistan    4536883671157         a****@gmail.com
3    Puerto Rico     3568819286614160      k****@gmail.com
4    Angola          2514167462583016      d****@gmail.com
Data Privacy and Anonymization in Python

產生合成資料

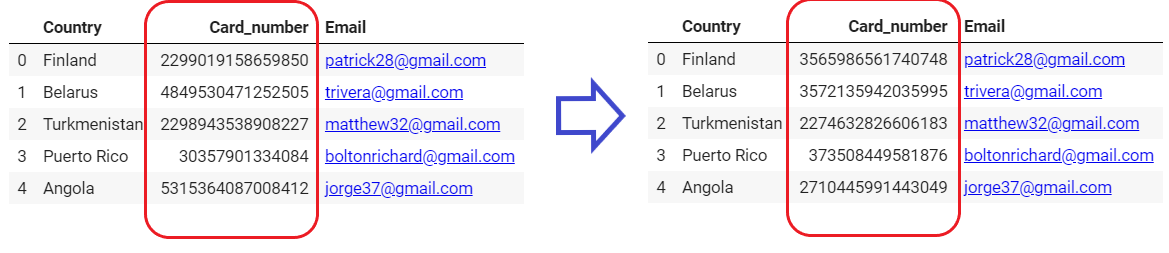
左側為包含卡號的原始資料表,右側為合成產生的新信用卡號

  • 以新產生且與原始相似的資料取代敏感資訊。
Data Privacy and Anonymization in Python

產生合成資料

# Import Faker class
from faker import Faker


# Create fake data generator fake_data = Faker()
# Generate a credit card number fake_data.credit_card_number()
3542216874440804
Data Privacy and Anonymization in Python

產生合成資料

# Mask card number with new generated data using a lambda function
df['card_number'] = df['card_number'].apply(lambda x: fake_data.credit_card_number())

# See the resulting pseudonymized data df.head()
     country         card_number            email
0    Finland         3596625386355448       [email protected]
1    Belarus         376297265347524        [email protected]
2    Turkmenistan    4377494880888682       [email protected]
3    Puerto Rico     30553931809810         [email protected]
4    Angola          4241735748382          [email protected]
Data Privacy and Anonymization in Python

產生其他型態的資料

fake_data.name()
'Kelly Clark'
fake_data.name_male()
'Antonio Henderson'
fake_data.name_female()
'Jennifer Ortega'
Data Privacy and Anonymization in Python

一起來練習吧!

Data Privacy and Anonymization in Python

Preparing Video For Download...