用階層概化資料
Data Privacy and Anonymization in Python

Rebeca Gonzalez
Data engineer
資料概化(generalization)
讓你以較不精確的值取代原始資料值。
- 「Dancer」->「Artist」
- 「Archaeologist」->「Scientist」
- 「Allergist」->「Doctor」
以階層進行資料概化
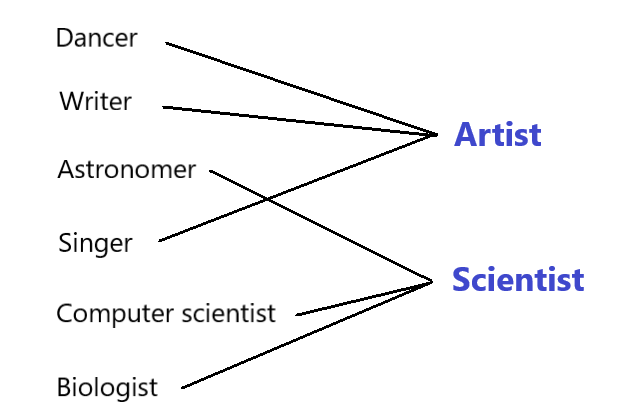
難民身分資料集
# Explore dataset
refugee_df.head()
     Nationality    Gender    RefugeeStatus    Year
0    russian        F         0                2010
1    colombian      M         0                2008
2    vietnamese     F         1                2008
3    korean         M         0                2010
4    ethiopian      F         1                2012
探索資料集
# Set k value to 4 k = 4# Calculate how many unique combinations are for nationality and gender df_count = df.groupby(['Nationality', 'Gender']).size().reset_index(name='Count')# Filter the rows that have a count value less than k df_count[df_count['Count'] < k]
      Nationality   Gender    Count
4     colombian     F         2
7     cuban         M         2
12    liberian      F         2
14    mexican       F         3
15    mexican       M         3
17    russian       M         1
20    ukranian      F         3
21    ukranian      M         1
以階層進行資料概化
# See the combination counts
df['Nationality'].value_counts()
belarusian    14
korean        14
ethiopian     10
chinese       10
vietnamese     9
taiwanese      9
colombian      6
cuban          6
russian        6
mexican        6
liberian       6
ukranian       4
Name: Nationality, dtype: int64
以階層進行資料概化
# Create hierarchies for origin countries
hierarchies = {'Europe': ['ukranian','russian','belarusian'],
               'America':['mexican','colombian','cuban'],
               'Asia': ['taiwanese','korean','chinese'],
               'Africa': ['ethiopian','liberian']}
以階層進行資料概化
# Creating hierachy father for each contry origin_hierarchy = {} for (key, countries) in hierarchies.items(): for country in countries: origin_hierarchy[country] = keyorigin_hierarchy
{'belarusian': 'Europe',
 'chinese': 'Asia',
 'colombian': 'America',
 'cuban': 'America',
 'ethiopian': 'Africa',
 'korean': 'Asia',
 'liberian': 'Africa',
 'mexican': 'America',
 'russian': 'Europe',
 'taiwanese': 'Asia',
 'ukranian': 'Europe'}
以階層進行資料概化
# Apply origin_hierarchy hierarchy generalization to Nationality df['Nationality_generalized'] = df['Nationality'].map(origin_hierarchy)# Explore resulting dataset df.head()
     Nationality   Gender    RefugeeStatus    Year    Nationality_generalized
0    korean        M         1                2019    Asia
1    ethiopian     M         1                2003    Africa
2    cuban         M         0                2015    America
3    cuban         F         0                2001    America
4    korean        M         0                2013    Asia
以階層進行資料概化
# Calculate how many unique combinations are for Nationality_generalized and Gender
df_count = df.groupby(['Nationality_generalized', 'Gender']).size()
                                                            .reset_index(name='Count')

# Filter the combinations that appear less than k times
df_count[df_count['Count'] < k]
Nationality_generalized Gender Count
更多關於 K-anonymity
類型:
- 限制式方法
- Mondrian 多維方法
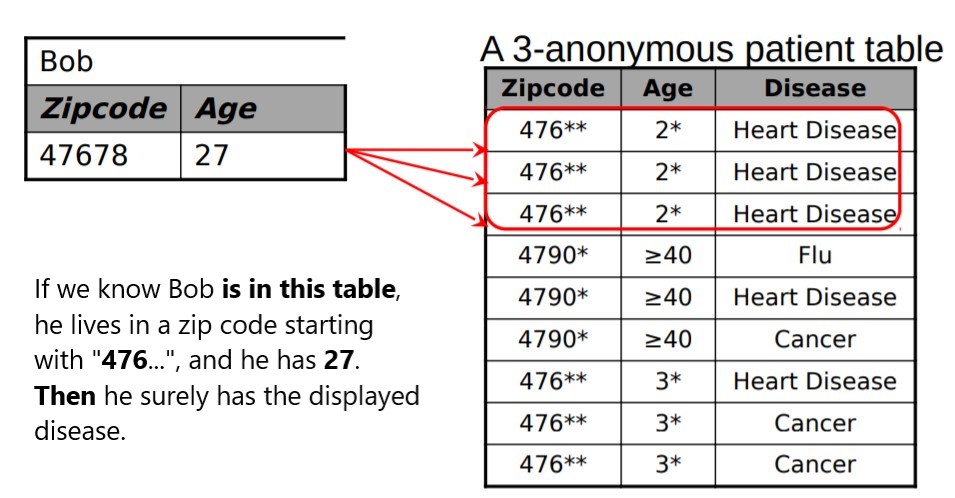
K-anonymity 有多安全?
一起來練習吧!
Data Privacy and Anonymization in Python

