R 中的類別資料推論
Andrew Bray
Assistant Professor of Statistics at Reed College
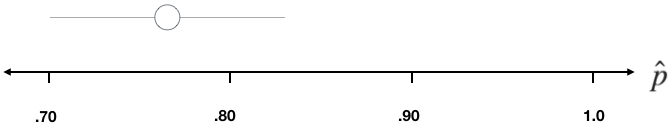
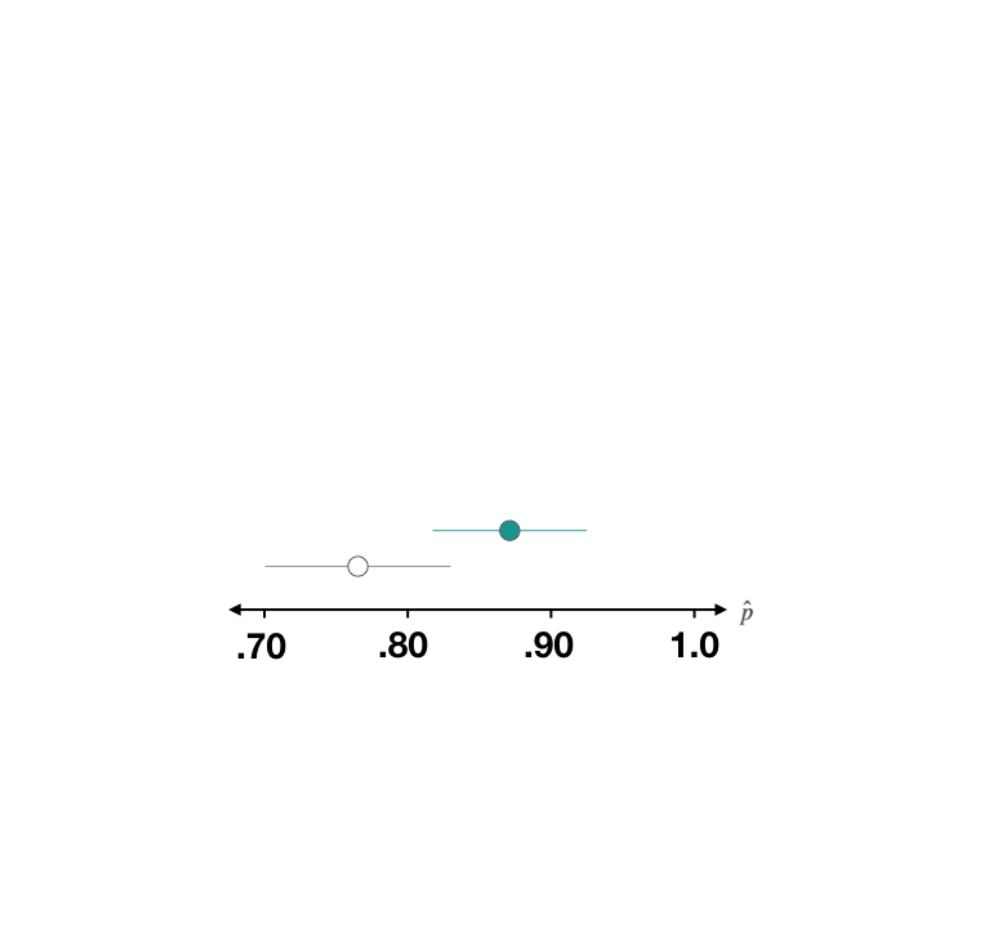
結論:美國人真實的快樂比例介於 0.705 到 0.841 之間。
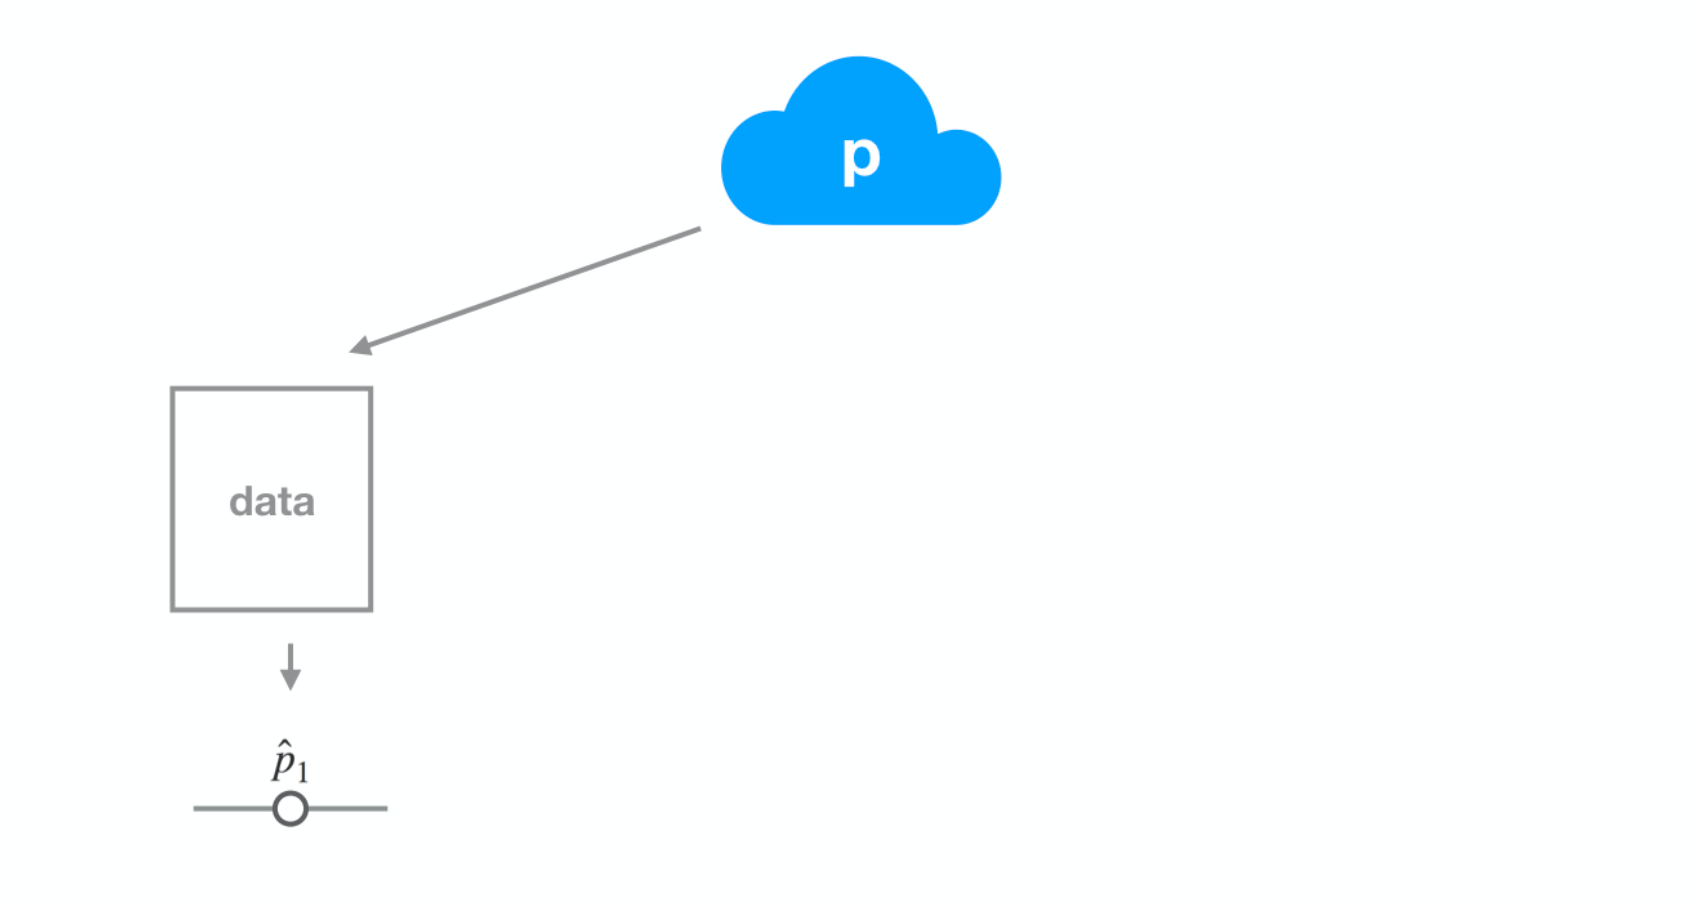
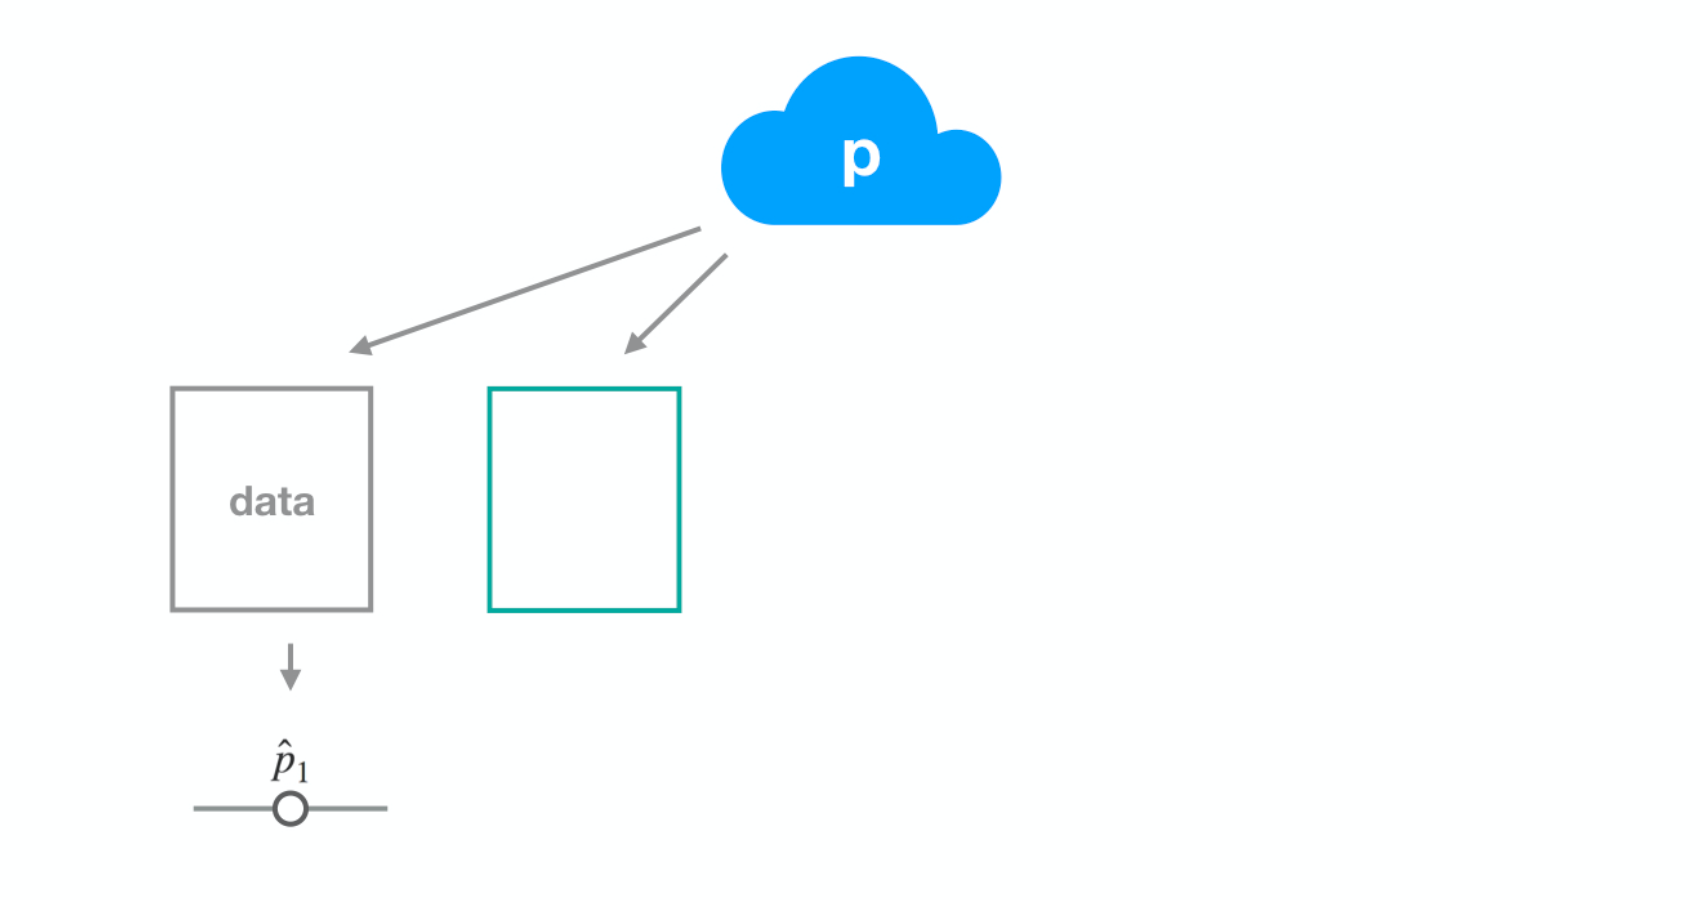
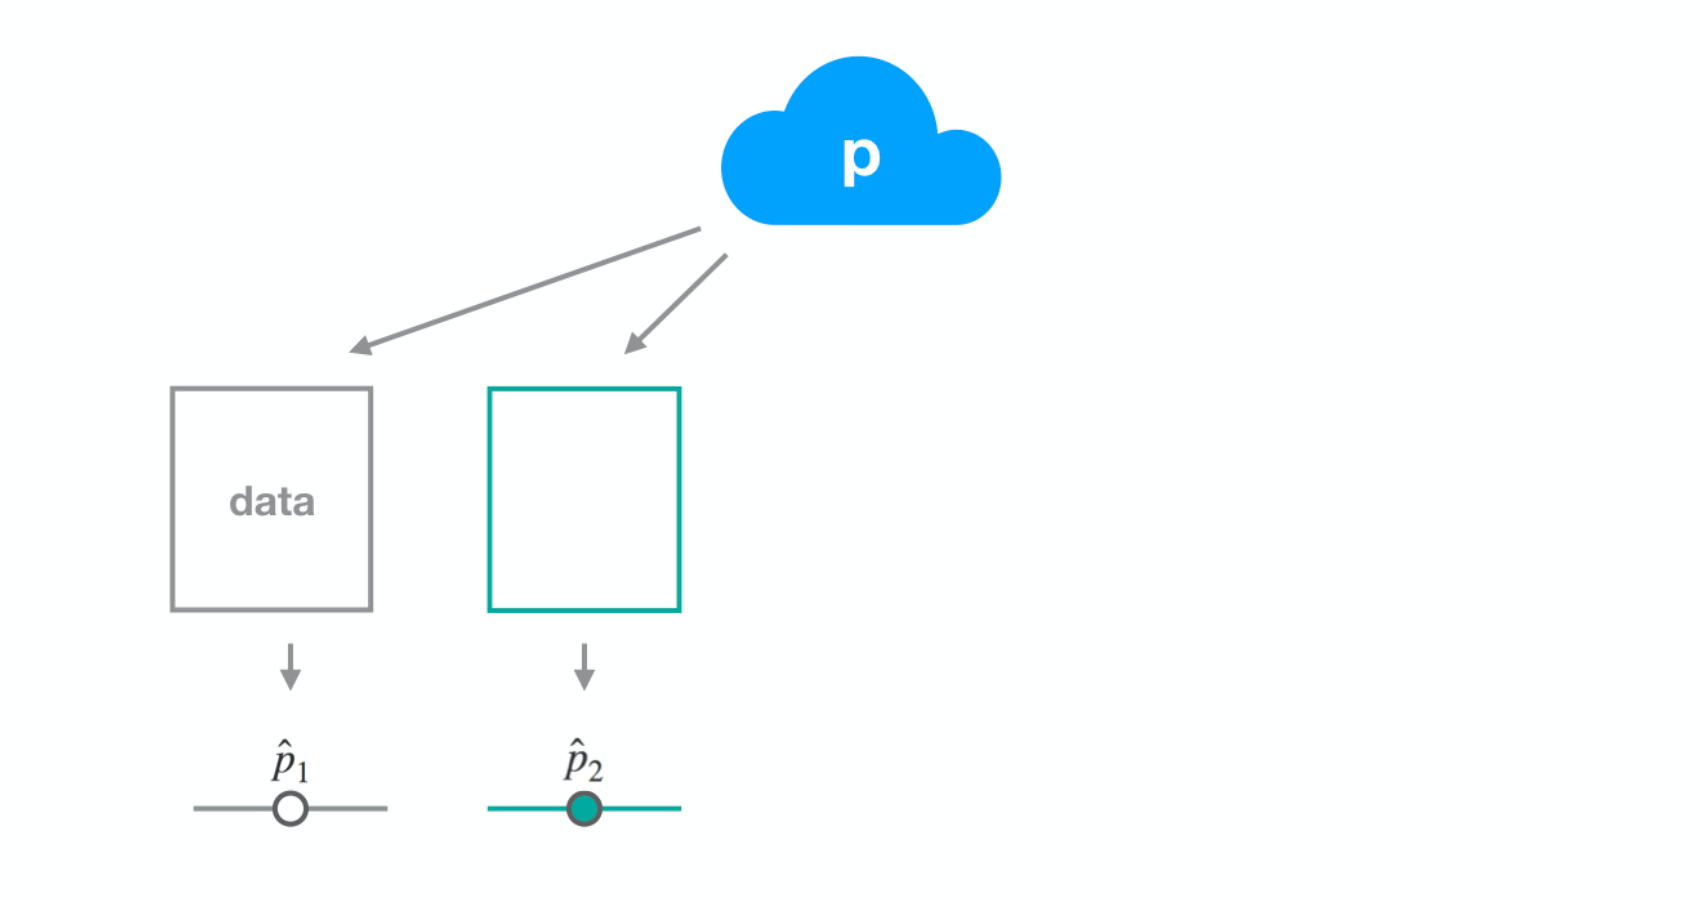
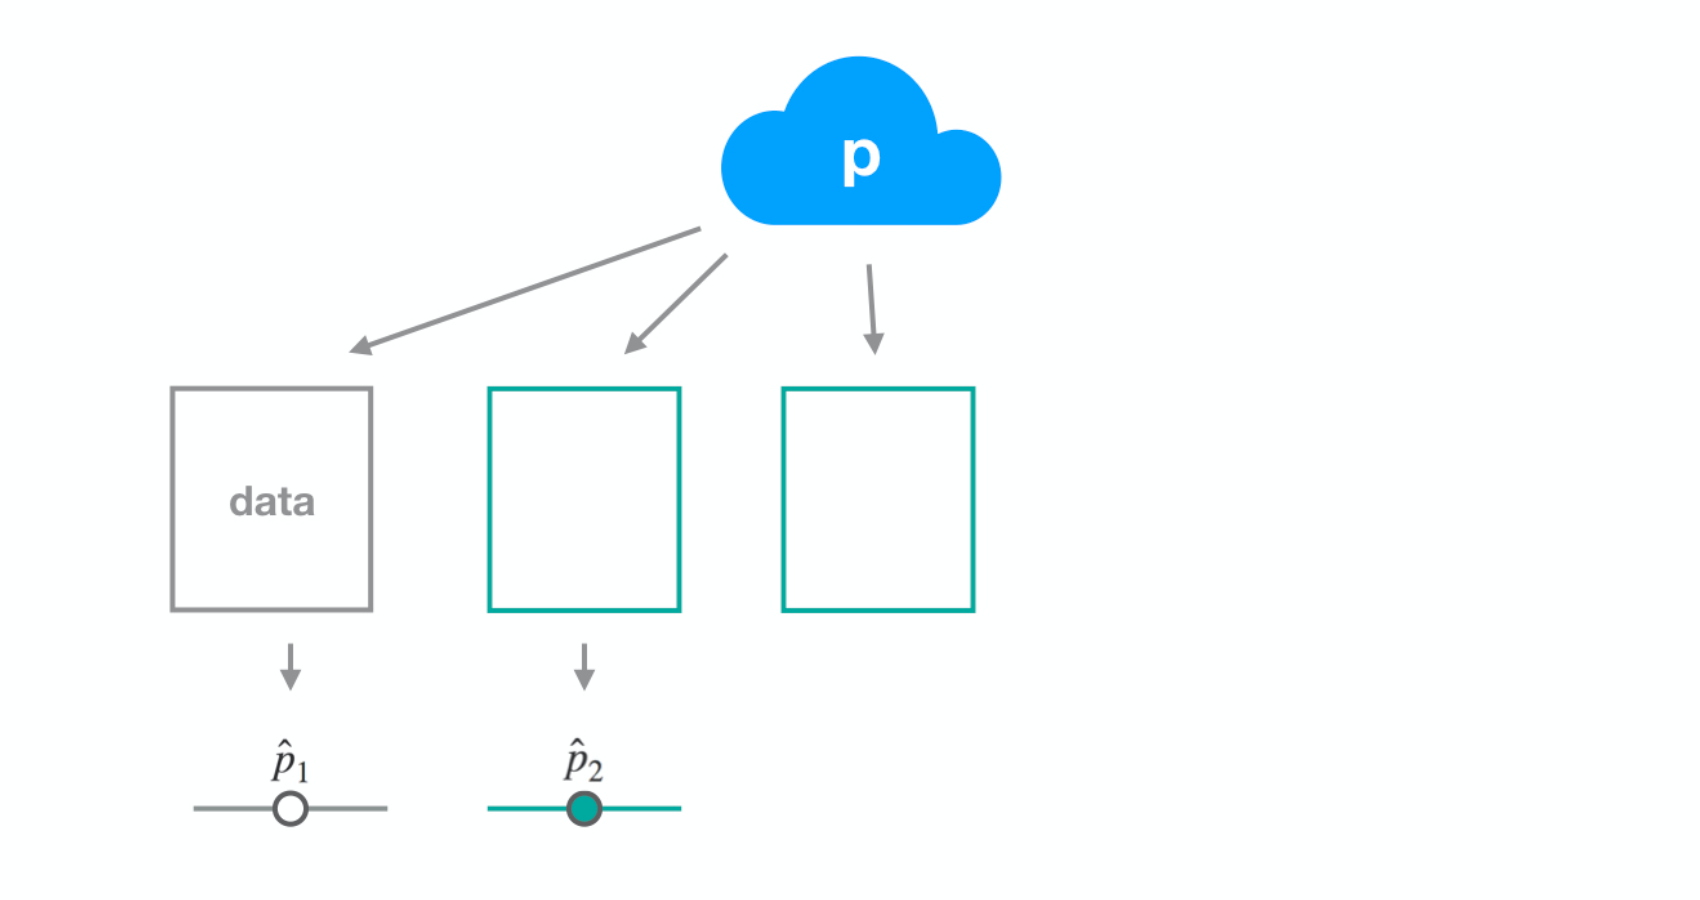
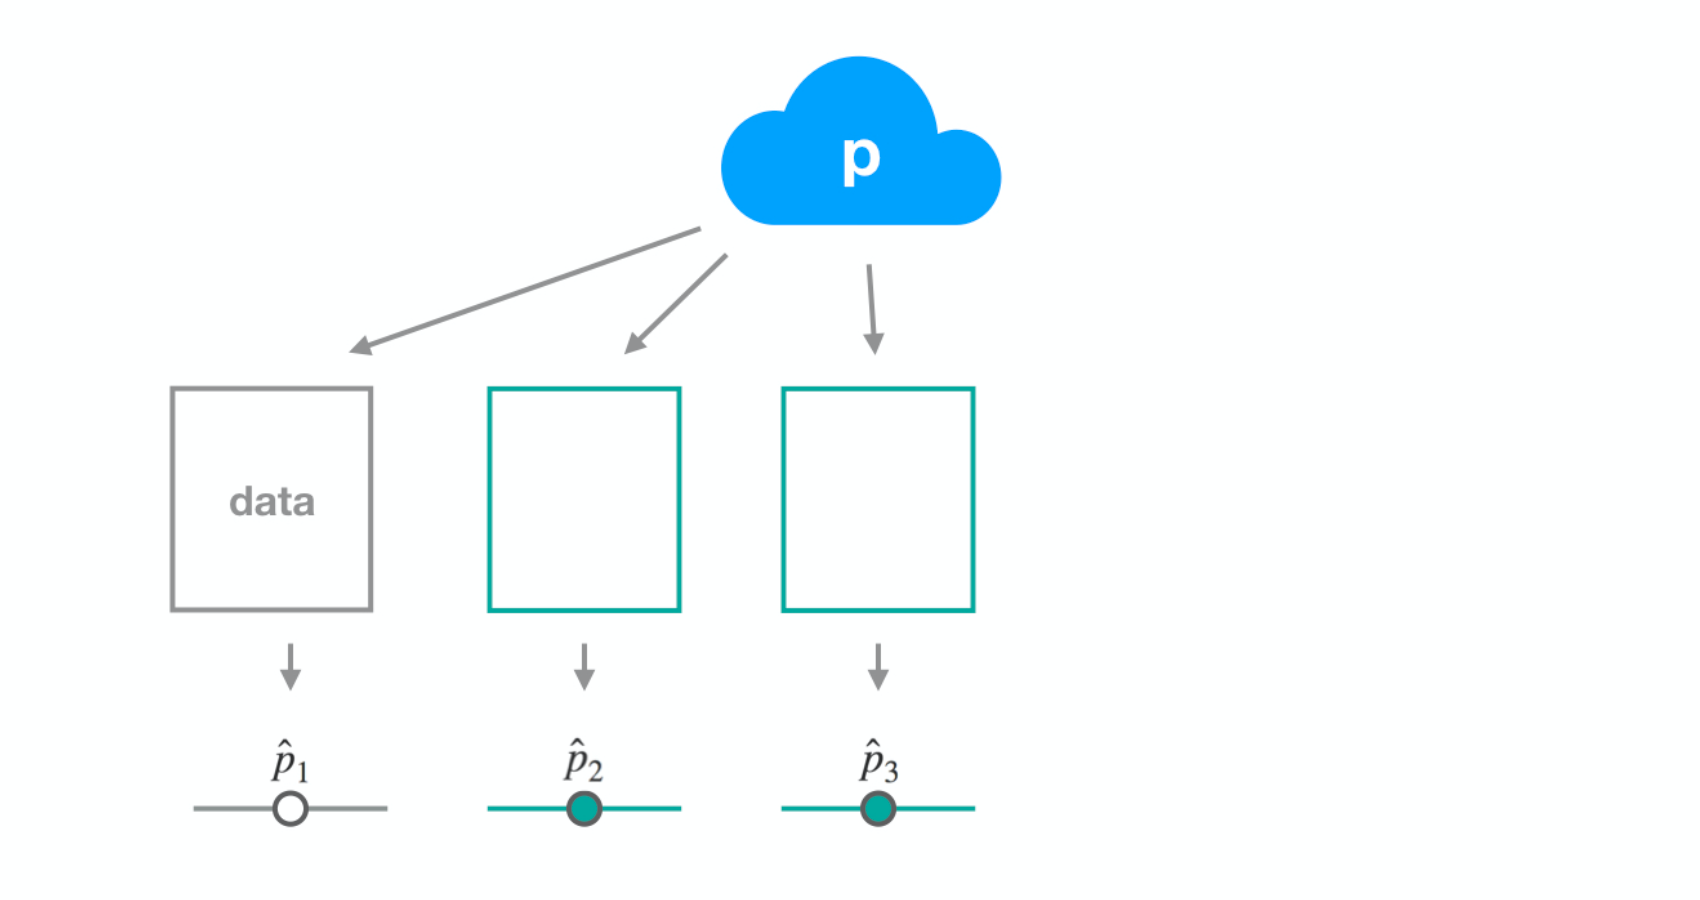
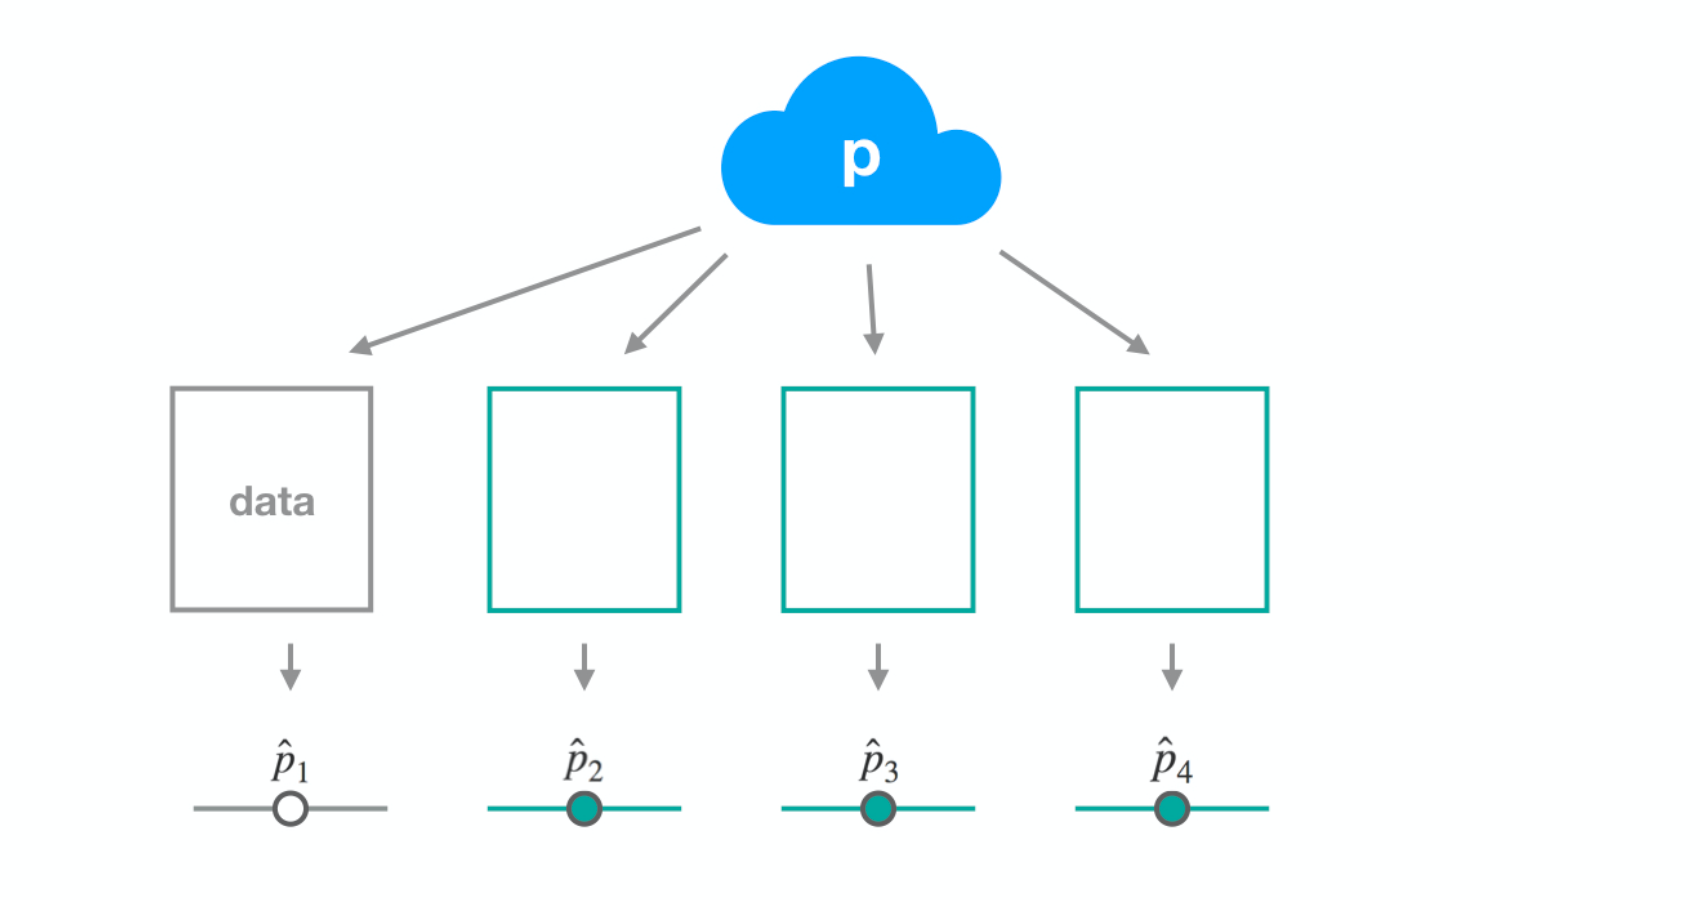
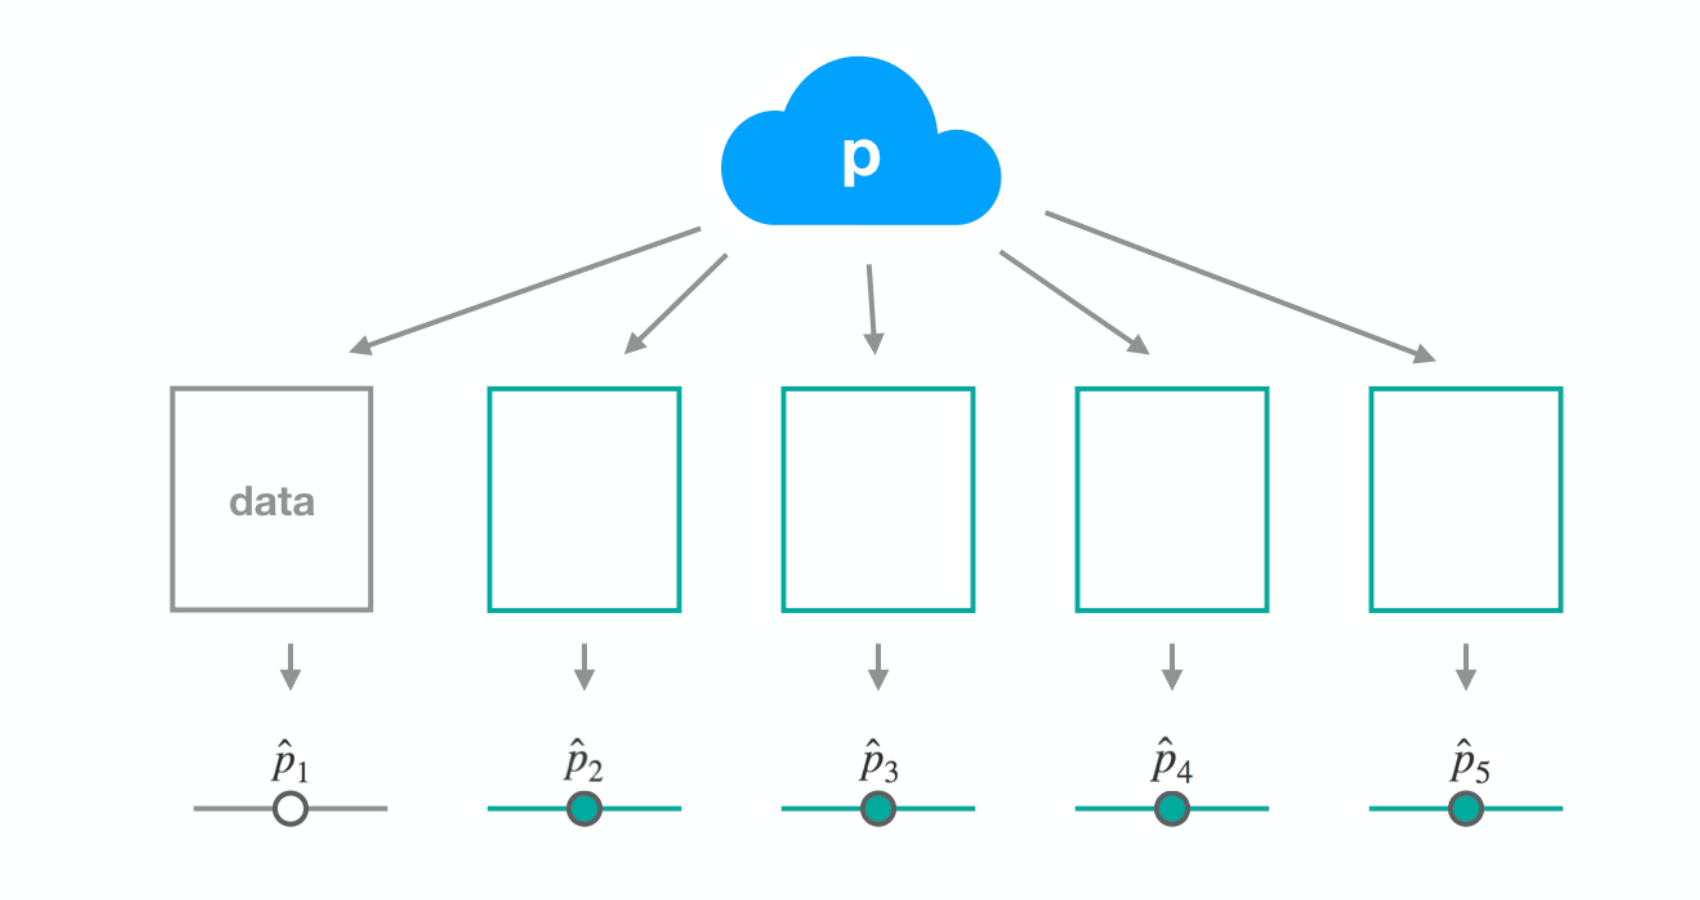
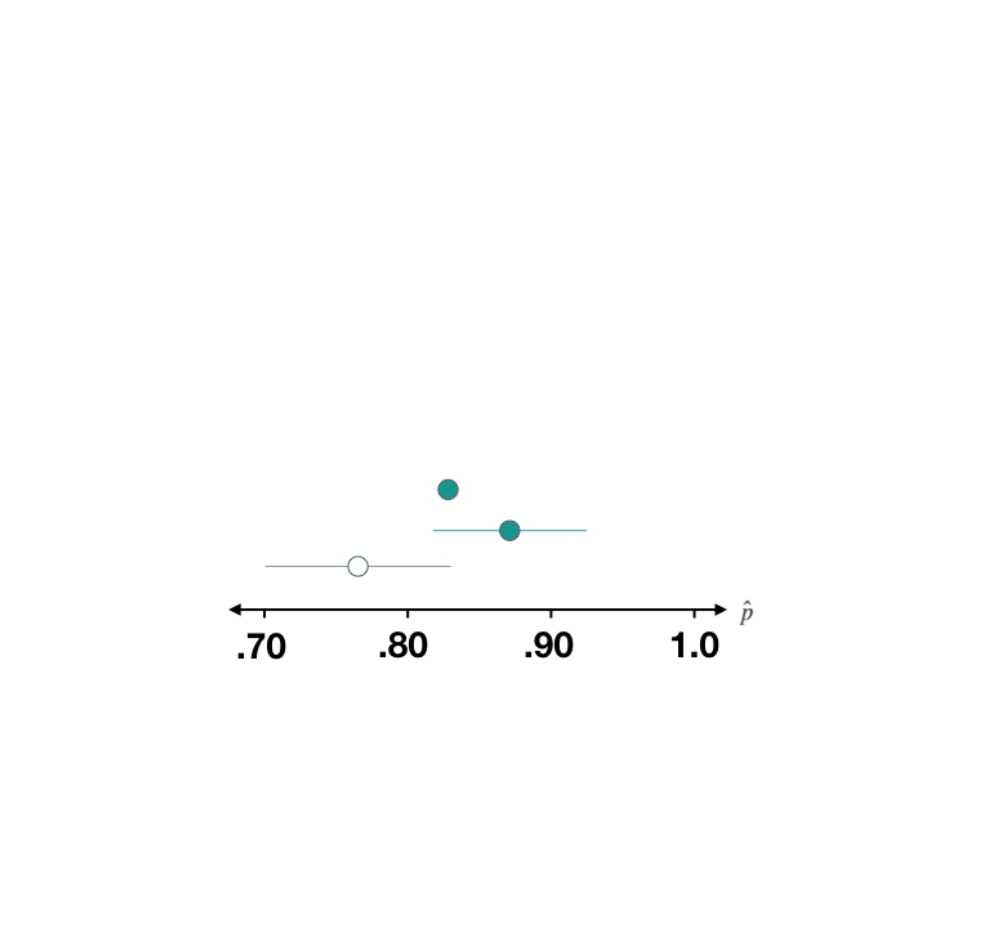
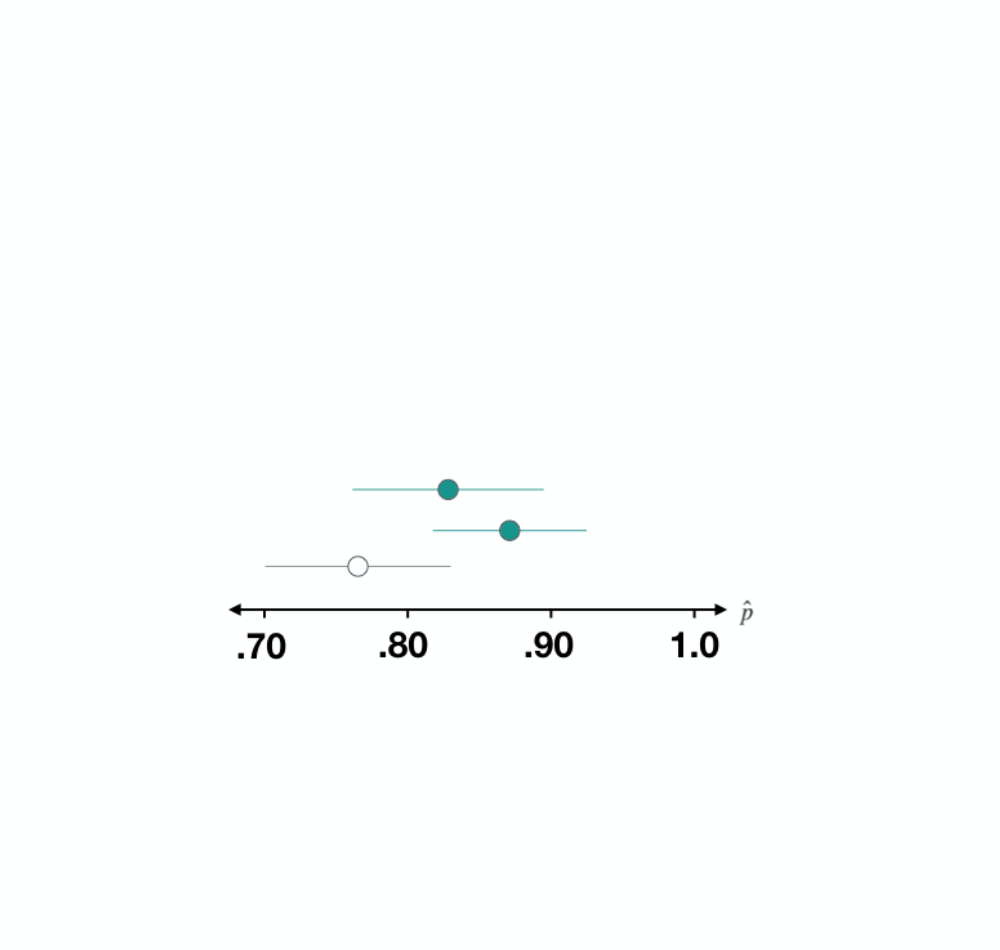
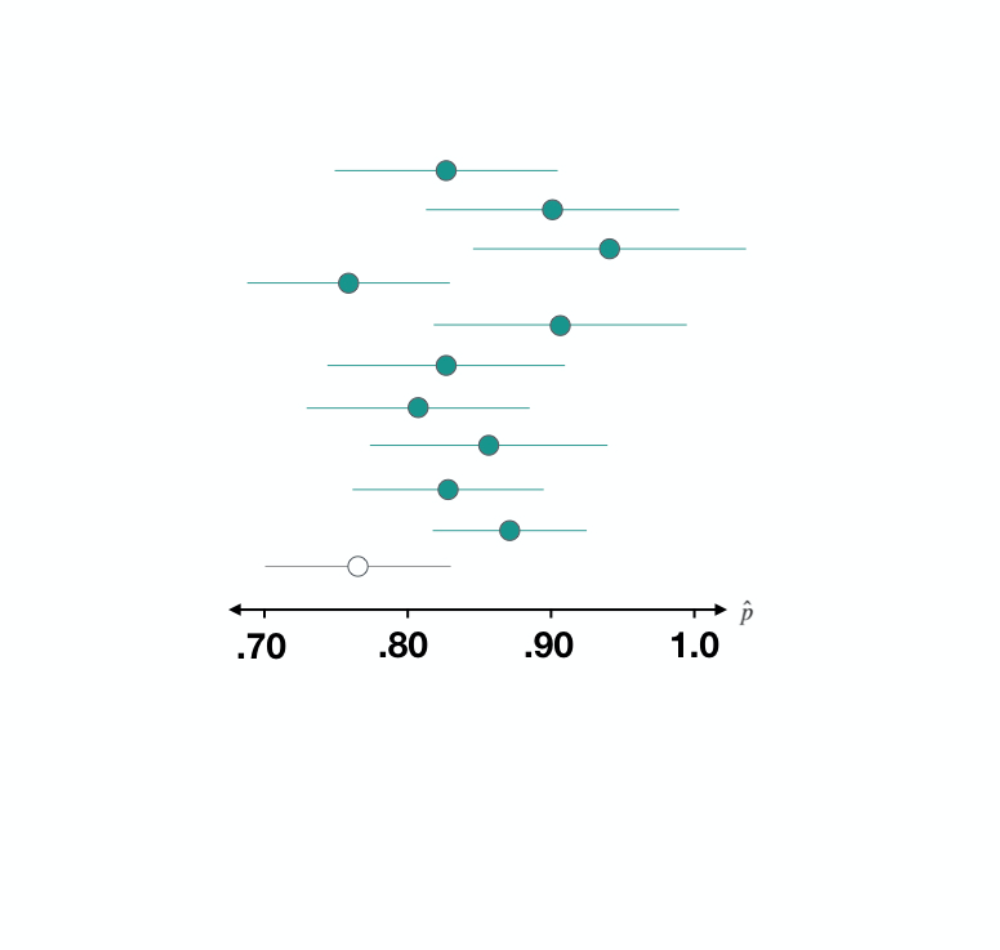
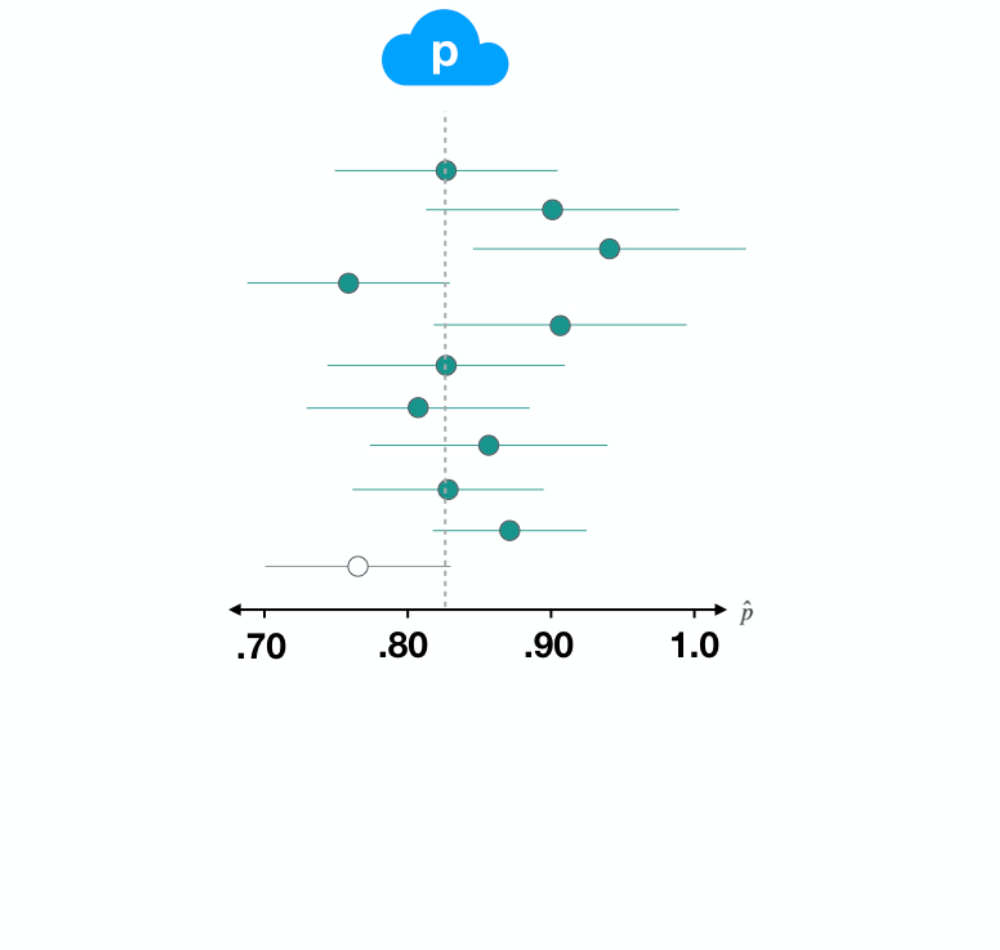
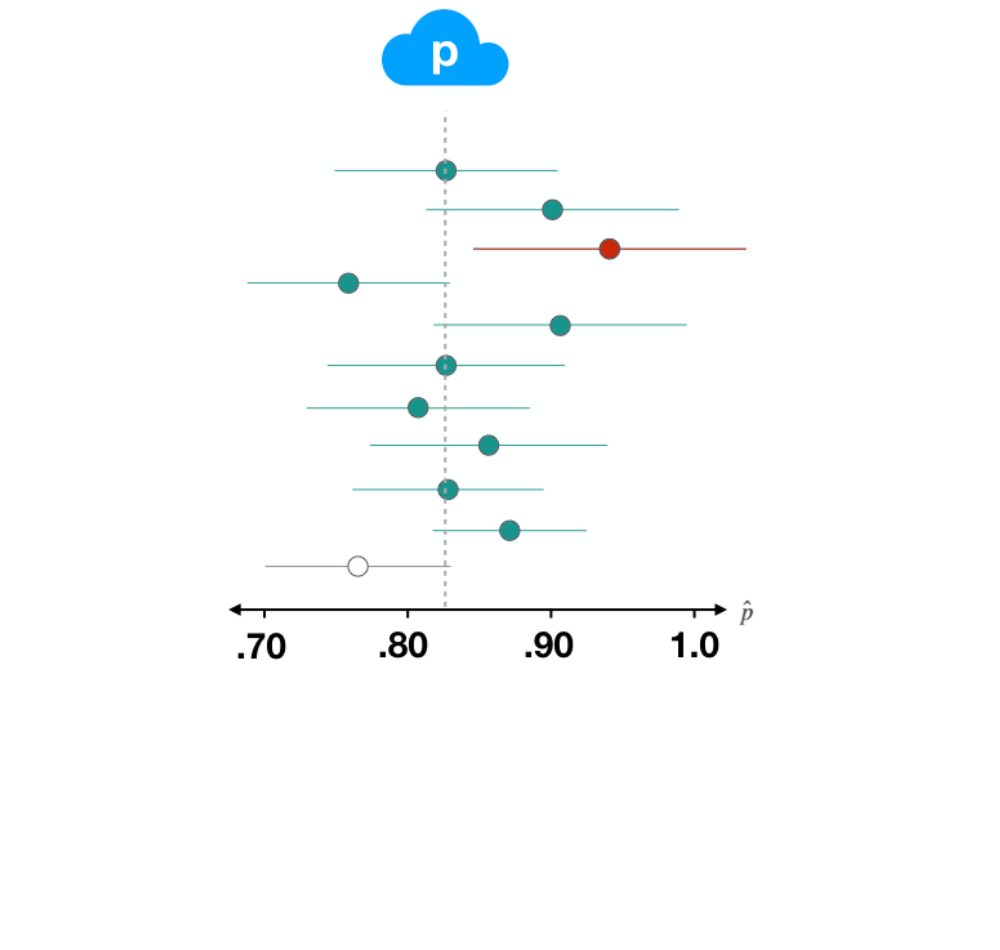
所謂「有信心」是什麼意思?
ds1 <- filter(gss, year == 2016)

p_hat <- ds1 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()

SE <- ds1 %>%
  specify(response = happy,
          success = "HAPPY") %>%
  generate(reps = 500,
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
ds1 <- filter(gss, year == 2016)
p_hat <- ds1 %>% summarize(mean(happy == "HAPPY")) %>% pull()
SE <- ds1 %>% specify(response = happy, success = "HAPPY") %>% generate(reps = 500, type = "bootstrap") %>% calculate(stat = "prop") %>% summarize(sd(stat)) %>% pull()
c(p_hat - 2 * SE, p_hat + 2 * SE)
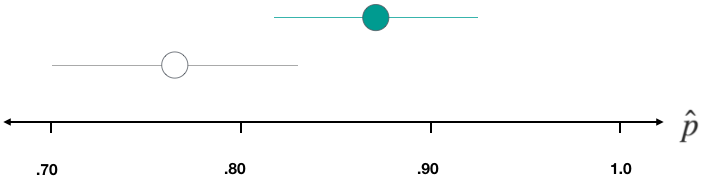
0.7073114 0.8393553
ds2 <- filter(gss, year == 2014)

p_hat <- ds1 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()

SE <- ds1 %>%
  specify(response = happy,
          success = "HAPPY") %>%
  generate(reps = 500,
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
ds2 <- filter(gss, year == 2014)
0.8348831 0.9384503
ds3 <- filter(gss, year == 2012)

p_hat <- ds1 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()

SE <- ds1 %>%
  specify(response = happy,
          success = "HAPPY") %>%
  generate(reps = 500,
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
ds3 <- filter(gss, year == 2012)
0.7626359 0.8906974
ds3 <- filter(gss, year == 2012)
p_hat <- ds3 %>%
  summarize(mean(happy == "HAPPY")) %>%
  pull()
SE <- ds3 %>%
  specify(response = happy,
          success = "HAPPY") %>%
  generate(reps = 500,
           type = "bootstrap") %>%
  calculate(stat = "prop") %>%
  summarize(sd(stat)) %>%
  pull()

c(p_hat - 2 * SE, p_hat + 2 * SE)
ds3 <- filter(gss, year == 2012) p_hat <- ds3 %>% summarize(mean(happy == "HAPPY")) %>% pull() SE <- ds3 %>% specify(response = happy, success = "HAPPY") %>% generate(reps = 500, type = "bootstrap") %>% calculate(stat = "prop") %>% summarize(sd(stat)) %>% pull()
解讀:「我們有 95% 的信心認為,美國人的真實快樂比例介於 0.705 到 0.841 之間。」
區間寬度受以下影響:
n
p