Dask DataFrame
在 Python 中使用 Dask 進行平行程式設計

James Fulton
Climate Informatics Researcher
pandas DataFrame vs. Dask DataFrame
import pandas as pd# 讀取單一 csv 檔案 pandas_df = pd.read_csv( "dataset/chunk1.csv" )
這會立即讀取一個 CSV 檔案。
import dask.dataframe as dd# 延遲讀取所有 csv 檔案 dask_df = dd.read_csv( "dataset/*.csv" )
這會延遲讀取 dataset 資料夾中的所有 CSV 檔案。
Dask DataFrame
print(dask_df)
Dask DataFrame Structure:
              ID     col1     col2    col3     col4     ...
npartitions=3
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 3 tasks
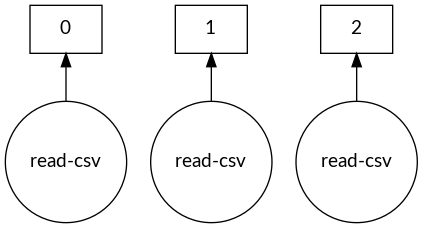
Dask DataFrame 任務圖
dask.visualize(dask_df)
控制區塊大小
# 設定區塊的最大記憶體 dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")print(dask_df)
Dask DataFrame Structure:
              ID     col1     col2    col3     col4     ...
npartitions=7
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 7 tasks
分割數量解釋
# 設定區塊的最大記憶體
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
為什麼是 7 個分割?
size      file
  9M      dataset/chunk1.csv
 18M      dataset/chunk2.csv
 32M      dataset/chunk3.csv
分割數量解釋
# 設定區塊的最大記憶體
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
為什麼是 7 個分割?
size      file
  9M      dataset/chunk1.csv    # 變成 1 個分割
 18M      dataset/chunk2.csv    # 變成 2 個分割
 32M      dataset/chunk3.csv    # 變成 4 個分割
使用 Dask DataFrame 做分析
- 選取欄位
col1 = dask_df['col1'] - 指派欄位
dask_df['double_col1'] = 2 * col1 - 數學運算,例如:
dask_df.std()
dask_df.min()
- 分組(groupby)
dask_df.groupby(col1).mean() - 甚至你先前用過的函式
dask_df.nlargest(n=3, columns='col1')
日期時間與其他 pandas 功能
import pandas as pd # 字串轉為 datetime 格式 pd.to_datetime(pandas_df['start_date'])# 存取 datetime 屬性 pandas_df['start_date'].dt.year pandas_df['start_date'].dt.day pandas_df['start_date'].dt.hour pandas_df['start_date'].dt.minute
import dask.dataframe as dd # 字串轉為 datetime 格式 dd.to_datetime(dask_df['start_date'])# 存取 datetime 屬性 dask_df['start_date'].dt.year dask_df['start_date'].dt.day dask_df['start_date'].dt.hour dask_df['start_date'].dt.minute
讓結果不再延遲
# 顯示 5 列
print(dask_df.head())
        ID     double_col1     col1    col2     col3     ...
0   543795              20       10     436        0     ...
1   874535              24       12     268        0     ...
2   781326              62       31     211        0     ...
3   112457              18        9     898        1     ...
4   103256             142       71     663        0     ...
# 將延遲的 Dask DataFrame 轉為記憶體內的 pandas DataFrame
results_df = df.compute()
將答案直接輸出成檔
# 7 個分割(區塊),所以輸出 7 個檔案
dask_df.to_csv('answer/part-*.csv')
part-0.csv
part-1.csv
part-2.csv
part-3.csv
part-4.csv
part-5.csv
part-6.csv
更快的檔案格式:Parquet
# 從 parquet 讀取
dask_df = dd.read_parquet('dataset_parquet')

# 存成 parquet
dask_df.to_parquet('answer_parquet')
- Parquet 讀取速度遠快於 CSV
- 寫入也可能更快
一起來練習吧!
在 Python 中使用 Dask 進行平行程式設計

