清理與前處理文字

R 的 Bag-of-Words 文本探勘

Ted Kwartler

Instructor

常見前處理函式
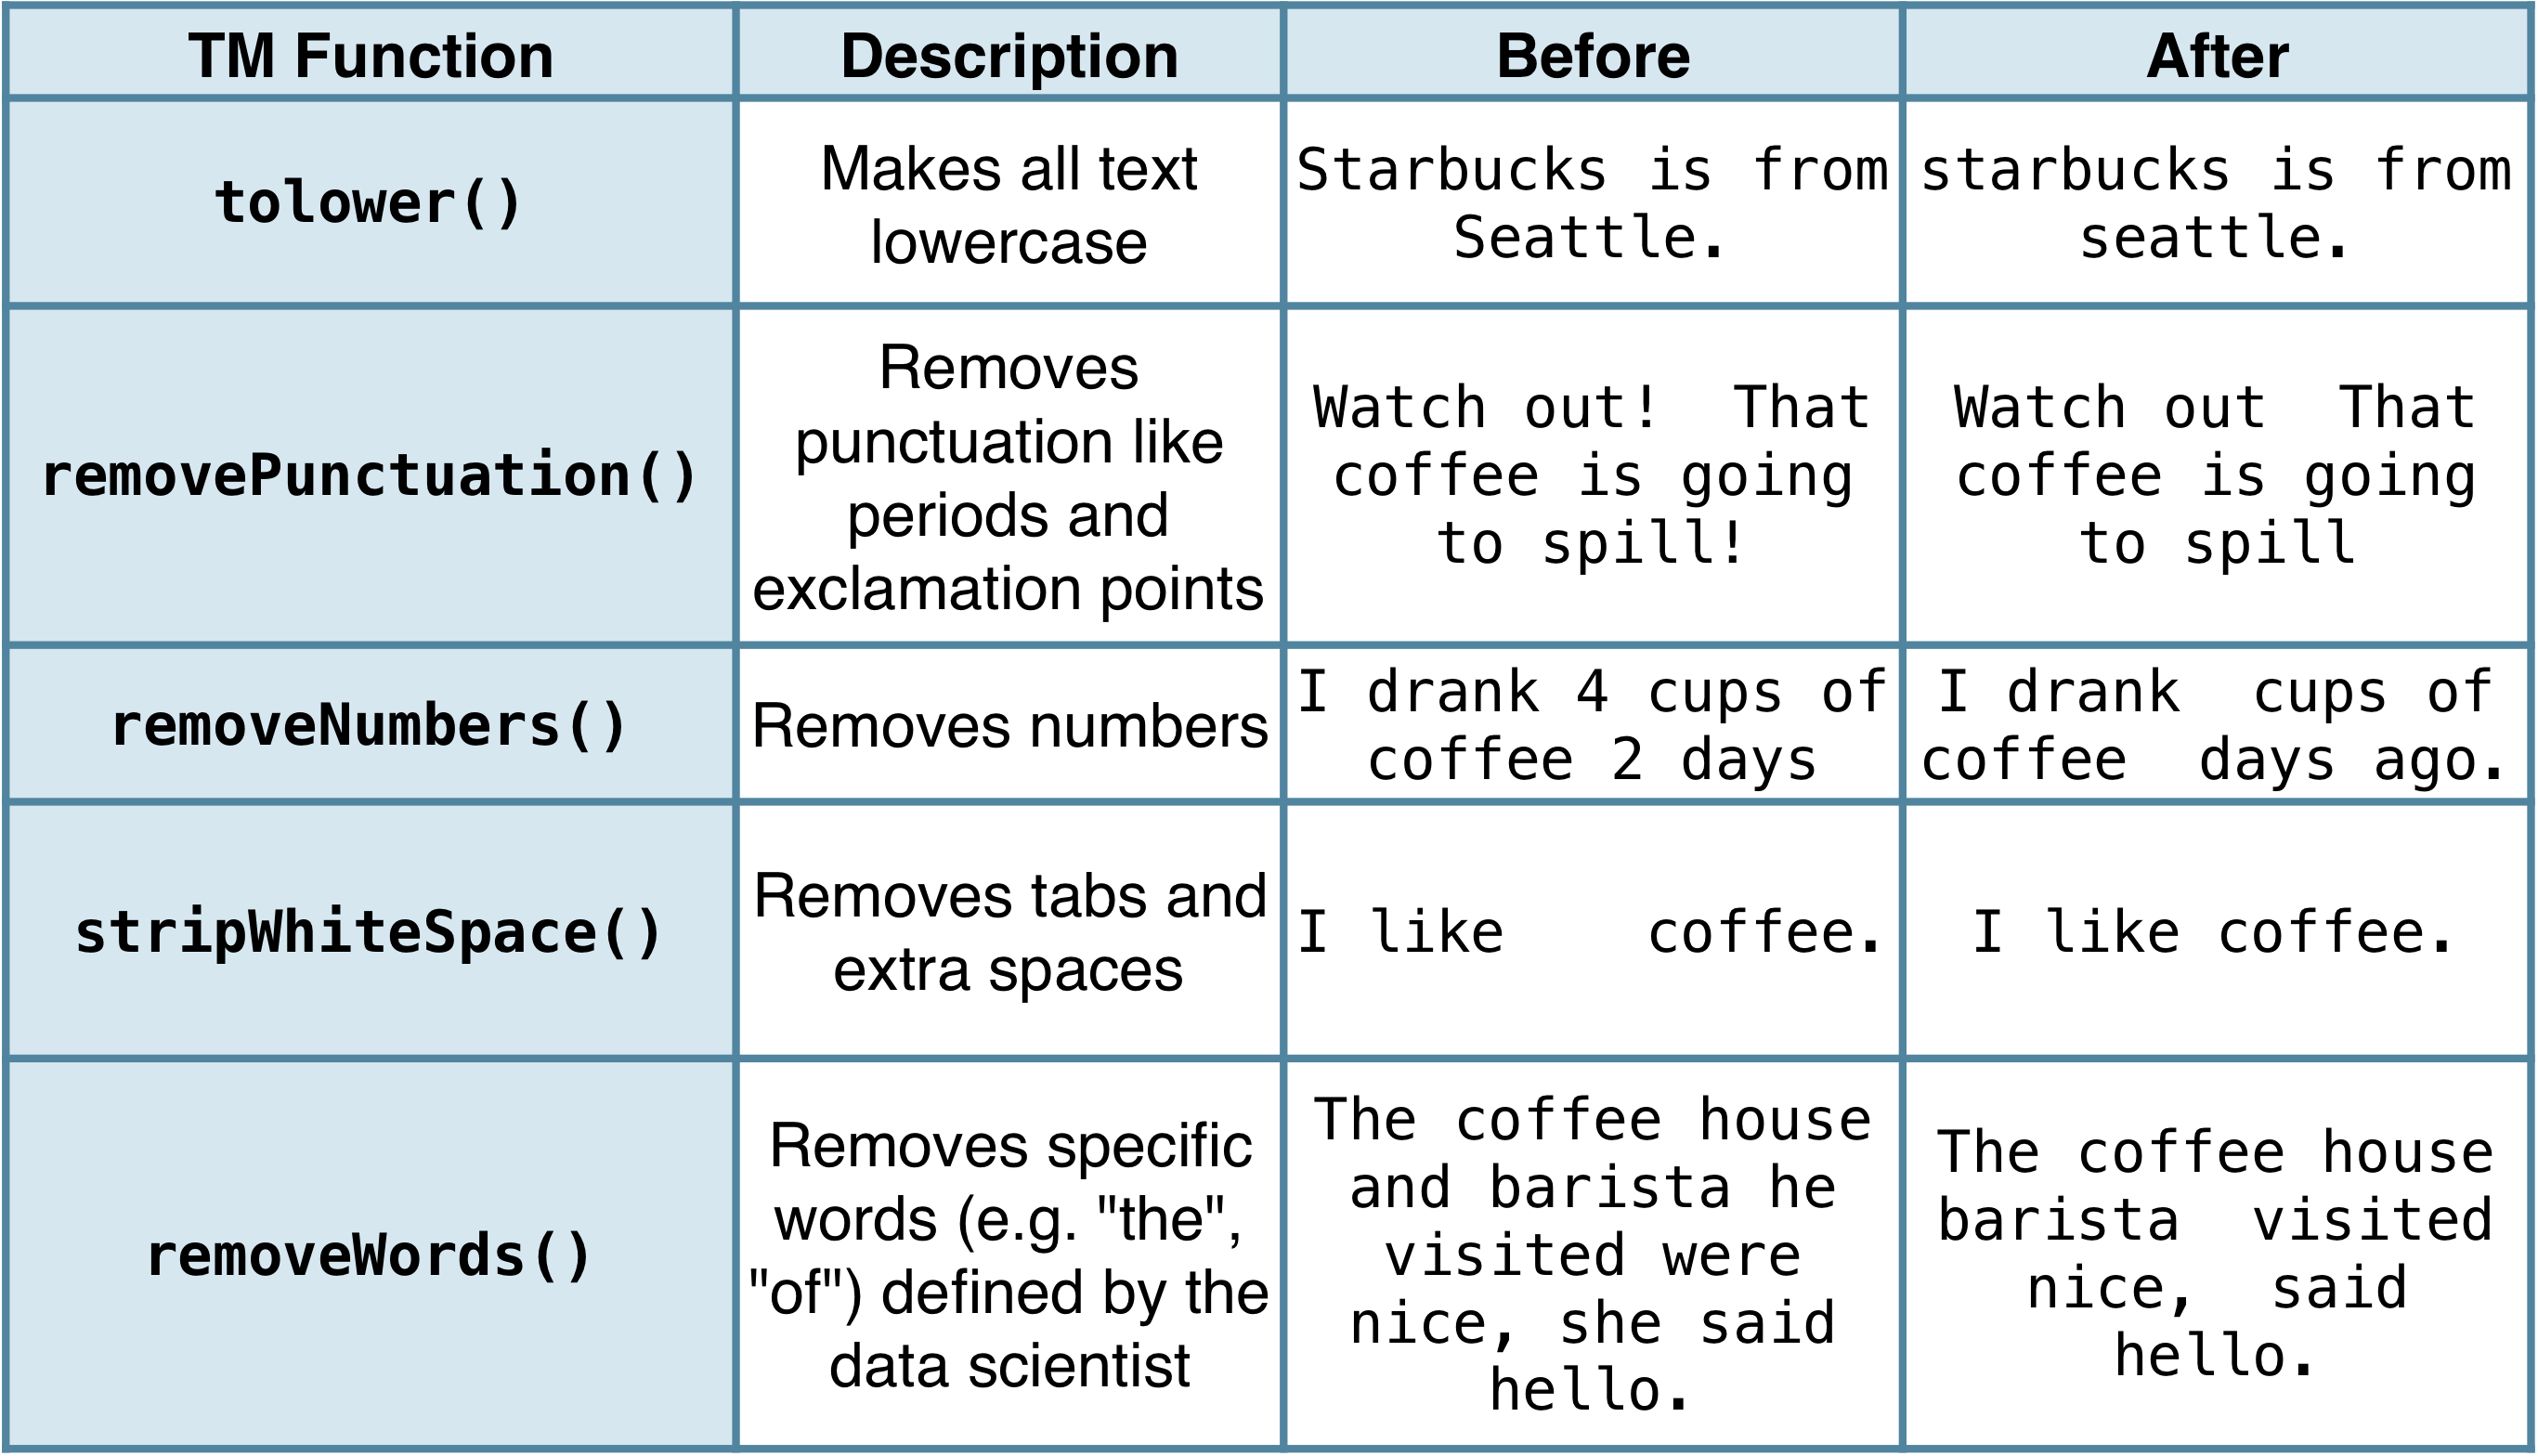
前處理函式示意

R 的 Bag-of-Words 文本探勘

實作前處理

前處理流程

# Make a vector source: coffee_source
coffee_source <- VectorSource(coffee_tweets)

# Make a volatile corpus: coffee_corpus coffee_corpus <- VCorpus(coffee_source)
# Apply various preprocessing functions tm_map(coffee_corpus, removeNumbers) tm_map(coffee_corpus, removePunctuation)
tm_map(coffee_corpus, content_transformer(replace_abbreviation))
R 的 Bag-of-Words 文本探勘

另一個前處理步驟:詞幹提取(stemming)

# Stem words
stem_words <- stemDocument(c("complicatedly", "complicated","complication"))
stem_words
"complic" "complic" "complic"
# Complete words using single word dictionary
stemCompletion(stem_words, c("complicate"))
     complic      complic      complic 
"complicate" "complicate" "complicate"
# Complete words using entire corpus
stemCompletion(stem_words, my_corpus)
R 的 Bag-of-Words 文本探勘

一起來練習吧!

R 的 Bag-of-Words 文本探勘

Preparing Video For Download...