ANOVA

R 數值資料推論

Mine Cetinkaya-Rundel

Associate Professor of the Practice, Duke University
跑者

R 數值資料推論

字彙分數與自我認定社會階級的 ANOVA

$H_0$:各社會階級的平均字彙分數相同,$\mu_{lower} = \mu_{working} = \mu_{middle} = \mu_{upper}$。

$H_A$:至少有一對社會階級的平均字彙分數不同。

R 數值資料推論

變異拆解

字彙分數的總變異:

  • 可歸因於社會階級差異的變異——「組間」變異
  • 其他因素造成的變異——「組內」變異
R 數值資料推論

ANOVA 輸出

library(broom)

aov(wordsum ~ class, gss) %>%
  tidy()
term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
R 數值資料推論

平方和(Sum of Squares)

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA
  • $SST = 236.5644 + 2869.8003 = 3106.365$ —— 衡量應變數的總變異
  • 計算方式與變異數相似(但未按樣本數縮放)
  • 解釋變異百分比 = $\frac{236.5644}{3106.365} = 7.6\%$
R 數值資料推論

F 統計量

term        df     sumsq    meansq   statistic p.value
class        3   236.5644  78.854810  21.73467       0
Residuals  791  2869.8003   3.628066        NA      NA

F 統計量 = 21.73467 = $\frac{between~group~var}{within~group~var}$
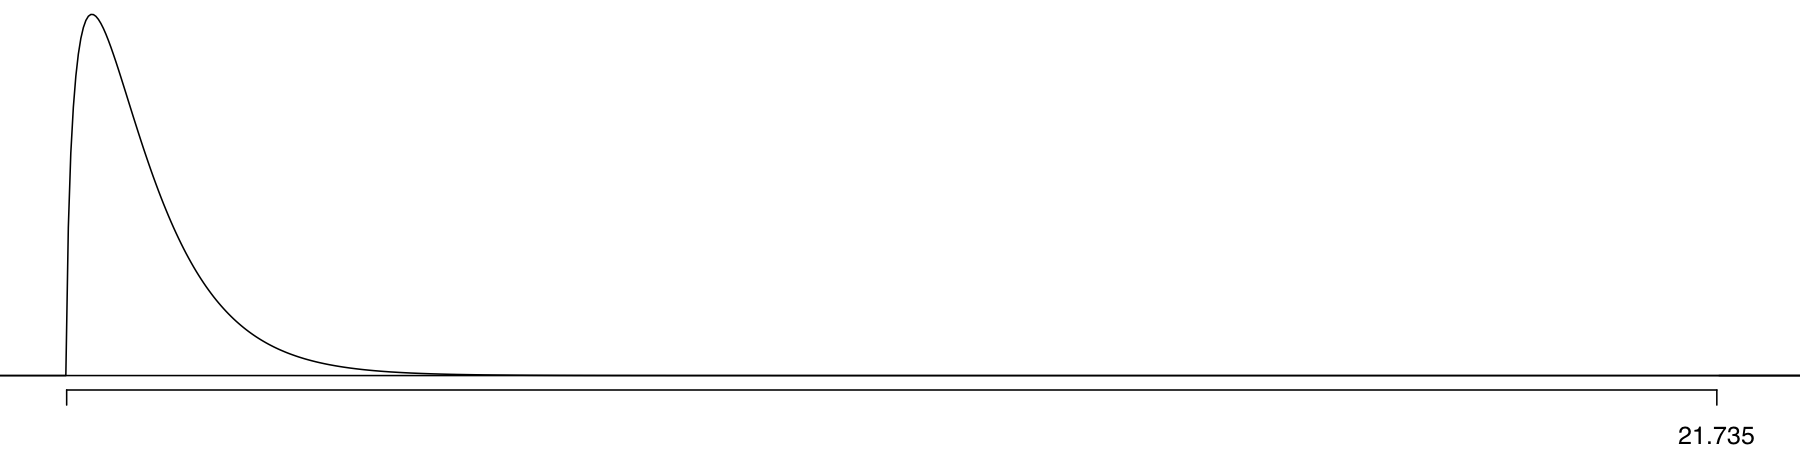
F 統計量與 p 值

R 數值資料推論

一起來練習吧!

R 數值資料推論

Preparing Video For Download...