Associate Professor of the Practice, Duke University
High School and Beyond
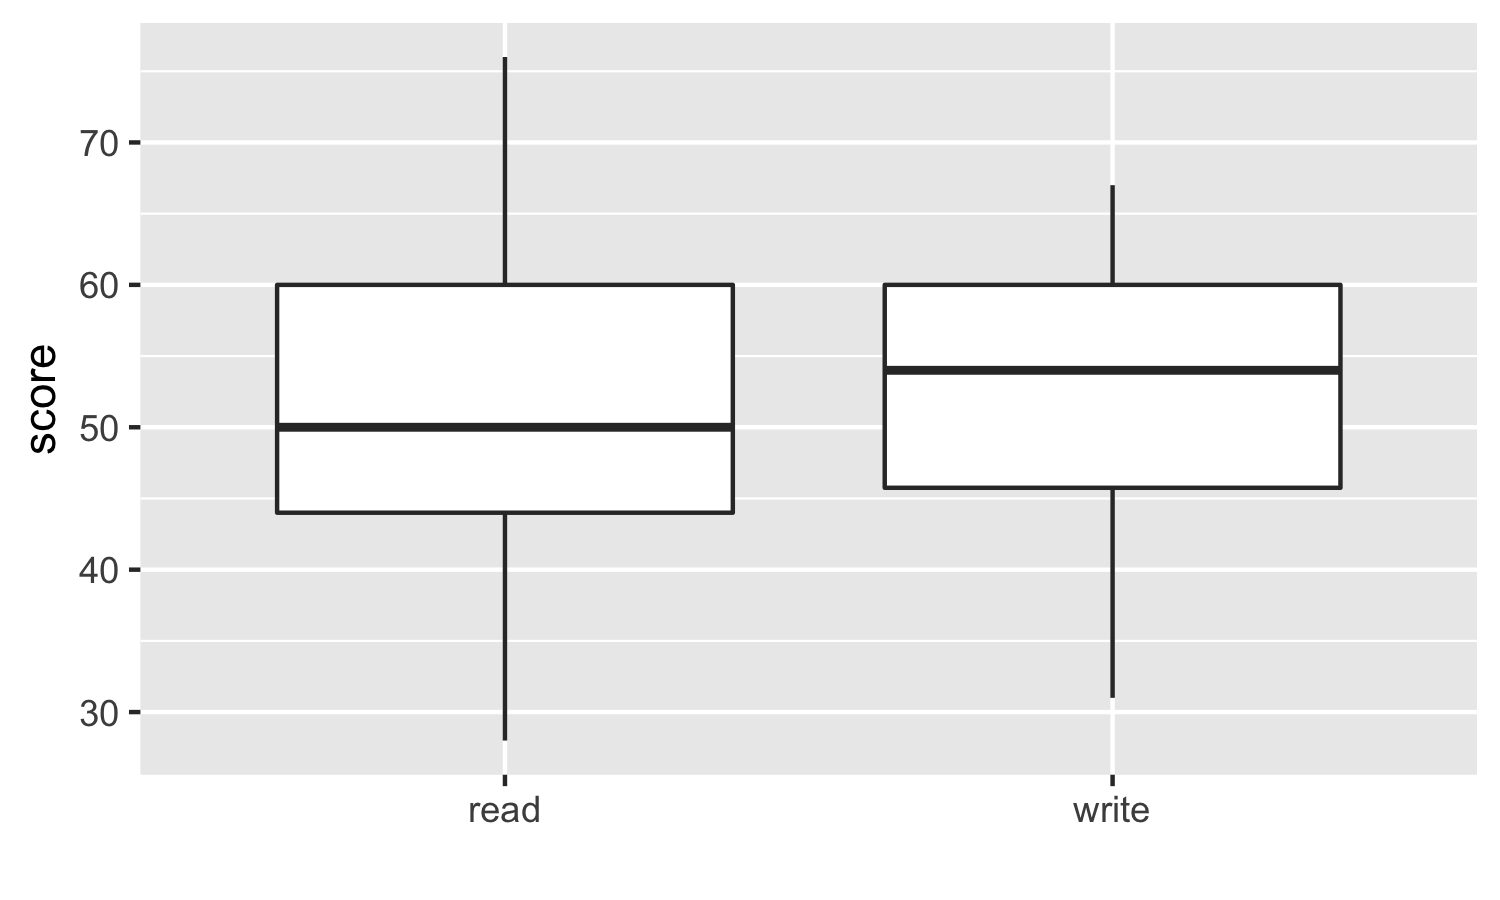
從 High School and Beyond 調查中隨機抽樣 200 筆觀測。相同學生各自參加閱讀與寫作測驗。乍看之下,閱讀與寫作分數的分配有何相同?又有何不同?
分數獨立嗎?
對同一位學生的閱讀與寫作分數,可以假設彼此獨立嗎?
大概不行!
分析成對資料
當兩組觀測有此種一一對應(非獨立)時,稱為成對資料。
分析成對資料時,常看每一對觀測的結果差異:
diff = read − write。
student
read
write
diff
1
57
52
5
2
68
59
9
3
44
33
11
...
...
...
...
200
63
65
-2
估計成對資料的平均差
建立平均閱讀與寫作分數之差的 95% 信賴區間。
估計成對資料的平均差
建立平均閱讀與寫作分數之差的 95% 信賴區間。
t.test(hsb2$diff, conf.level = 0.95)
估計成對資料的平均差
建立平均閱讀與寫作分數之差的 95% 信賴區間。
t.test(hsb2$diff, conf.level = 0.95)
    One Sample t-test
data:  hsb2$diff
t = -0.86731, df = 199, p-value = 0.3868
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
 -1.7841424  0.6941424
sample estimates:
mean of x
   -0.545