重複配對

R 的 data.table 資料合併

Scott Ritchie

Postdoctoral Researcher in Systems Genomics

連接鍵重複

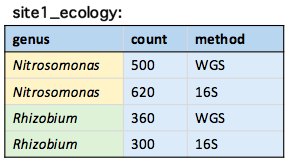
# Which bacteria could be found at both sites using any method?
site1_ecology[site2_ecology, on = .(genus)] 
R 的 data.table 資料合併

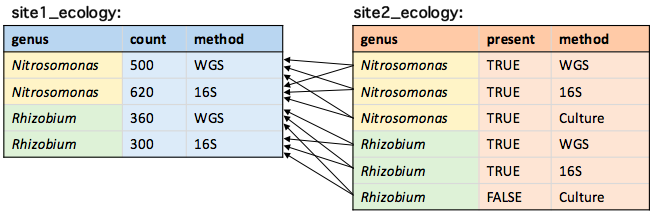
倍數配對的錯誤

site1_ecology[site2_ecology, on = .(genus)]

Error in vecseq(f__, len__, if (allow.cartesian || notjoin || 
!anyDuplicated(f__,  : 
  Join results in 12 rows; more than 10 = nrow(x)+nrow(i). Check for 
  duplicate key values in i each of which join to the same group in x over 
  and over again. If that's ok, try by=.EACHI to run j for each group to 
  avoid the large allocation. If you are sure you wish to proceed, rerun 
  with allow.cartesian=TRUE. Otherwise, please search for this error message 
  in the FAQ, Wiki, Stack Overflow and data.table issue tracker for advice.
R 的 data.table 資料合併

允許倍數配對

allow.cartesian = TRUE 允許繼續連接:

# data.table syntax
site1_ecology[site2_ecology, on = .(genus), allow.cartesian = TRUE]
# merge()
merge(site1_ecology, site2_ecology, by = "genus", allow.cartesian = TRUE)
R 的 data.table 資料合併

允許倍數配對

site1_ecology[site2_ecology, on = .(genus), allow.cartesian = TRUE]
           genus count method present i.method
 1: Nitrosomonas   500    WGS    TRUE      WGS
 2: Nitrosomonas   620    16S    TRUE      WGS
 3: Nitrosomonas   500    WGS    TRUE      16S
 4: Nitrosomonas   620    16S    TRUE      16S
 5: Nitrosomonas   500    WGS    TRUE  Culture
 6: Nitrosomonas   620    16S    TRUE  Culture
 7:    Rhizobium   360    WGS    TRUE      WGS
 8:    Rhizobium   300    16S    TRUE      WGS
 9:    Rhizobium   360    WGS    TRUE      16S
10:    Rhizobium   300    16S    TRUE      16S
11:    Rhizobium   360    WGS   FALSE  Culture
12:    Rhizobium   300    16S   FALSE  Culture
R 的 data.table 資料合併

遺漏值

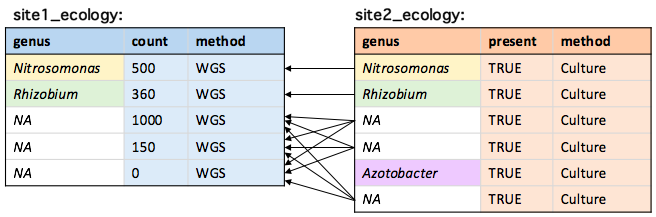
遺漏值(NA)會彼此配對:

R 的 data.table 資料合併

篩除遺漏值

可用 !is.na() 篩出含遺漏值的列。

site1_ecology <- site1_ecology[!is.na(genus)]
site1_ecology
          genus count method
1: Nitrosomonas   500    WGS
2:    Rhizobium   360    WGS
site2_ecology <- site2_ecology[!is.na(genus)]
site2_ecology
          genus present  method
1: Nitrosomonas    TRUE Culture
2:    Rhizobium    TRUE Culture
3:  Azotobacter    TRUE Culture
R 的 data.table 資料合併

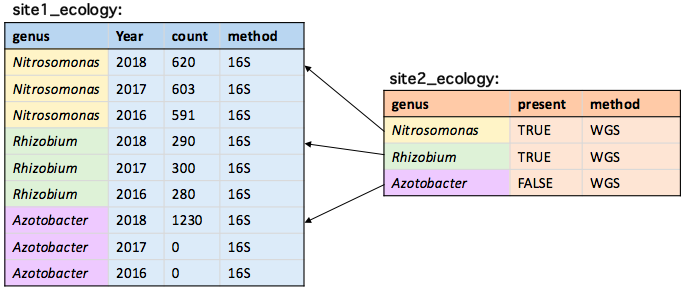
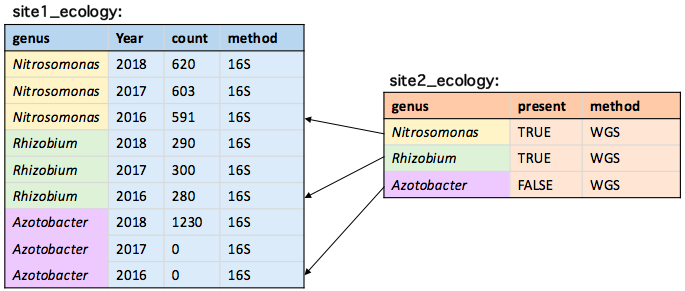
只保留第一個配對

site1_ecology[site2_ecology, on = .(genus), mult = "first"]
R 的 data.table 資料合併

只保留最後一個配對

children[parents, on = .(parent = name), mult = "last"]
R 的 data.table 資料合併

辨識並移除重複

duplicated():哪些列是重複?

unique():將 data.table 過濾為唯一列

R 的 data.table 資料合併

`duplicated()` 函式

使用所有欄位的值:

duplicated(site1_ecology)
FALSE FALSE FALSE FALSE

使用欄位子集的值:

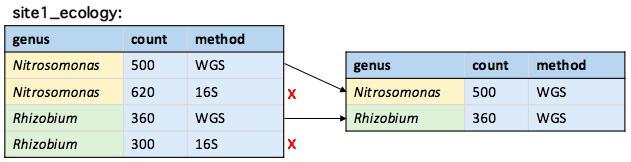
duplicated(site1_ecology, 
           by = "genus")
FALSE TRUE FALSE TRUE

R 的 data.table 資料合併

`unique()` 函式

unique(site1_ecology, by = "genus")
R 的 data.table 資料合併

變更搜尋順序

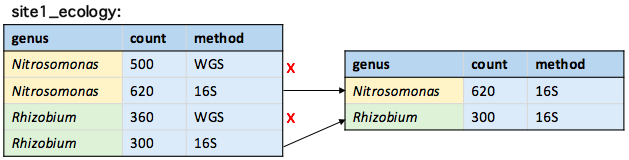
fromLast = TRUE 會改為自最後一列開始搜尋。

duplicated(site1_ecology, by = "genus", fromLast = TRUE)
TRUE FALSE TRUE FALSE
unique(site1_ecology, by = "genus", fromLast = TRUE)
R 的 data.table 資料合併

一起來練習吧!

R 的 data.table 資料合併

Preparing Video For Download...