平均值補值

在 R 中以插補處理遺漏值

Michal Oleszak

Machine Learning Engineer

補值術語

Imputation(補值)=對遺漏值做出有根據的推測

  • 捐贈式補值(donor-based):用其他完整觀測填補遺漏值。
  • 模型式補值(model-based):用統計或機器學習模型預測遺漏值。

本章聚焦捐贈式方法:

  • 平均值補值
  • 熱牌補值(hot-deck)
  • kNN 補值
在 R 中以插補處理遺漏值

平均值補值

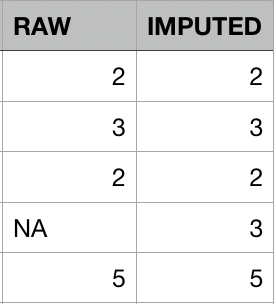
一個含兩欄的表格:左為原始資料,含一個遺漏值;右為補值後資料,該遺漏值以平均值補上。

平均值補值適用於圍繞長期平均隨機波動的時間序列資料。

對橫斷面資料,平均值補值通常很差:

  • 破壞變數間的關係。
  • 補上的值沒有變異。
在 R 中以插補處理遺漏值

實作平均值補值

任務:對 NHANES 資料的 HeightWeight 做平均值補值。

  • 為每個原本遺漏的值建立二元指標。
nhanes <- nhanes %>% 
  mutate(Height_imp = ifelse(is.na(Height), TRUE, FALSE)) %>% 
  mutate(Weight_imp = ifelse(is.na(Weight), TRUE, FALSE))
  • 以各自的平均數替換 HeightWeight 中的遺漏值。
nhanes_imp <- nhanes %>% 
  mutate(Height = ifelse(is.na(Height), mean(Height, na.rm = TRUE), Height)) %>% 
  mutate(Weight = ifelse(is.na(Weight), mean(Weight, na.rm = TRUE), Weight))
在 R 中以插補處理遺漏值

NHANES 平均值補值後的資料

nhanes_imp %>%
    select(Weight, Height, Height_imp, Weight_imp) %>%
    head()
     Weight   Height Height_imp Weight_imp
1  73.20000 166.2499       TRUE      FALSE
2  72.30000 166.2499       TRUE      FALSE
3  57.70000 158.9000      FALSE      FALSE
4  88.90000 183.3000      FALSE      FALSE
5  45.10000 157.6000      FALSE      FALSE
6  66.77065 158.4000      FALSE       TRUE
在 R 中以插補處理遺漏值

評估補值品質:邊際圖(margin plot)

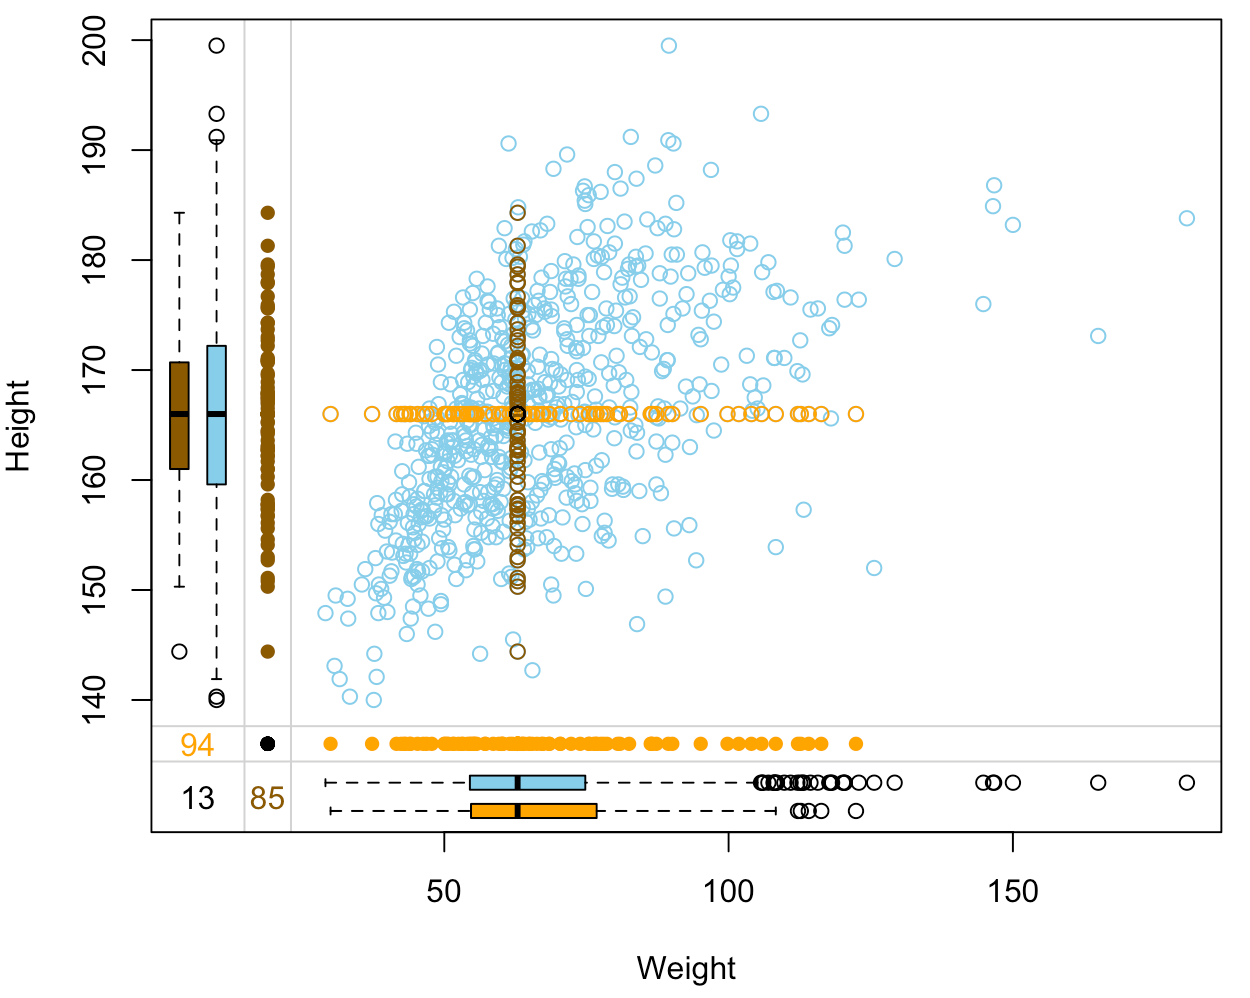
nhanes_imp %>% select(Weight, Height, Height_imp, Weight_imp) %>% marginplot(delimiter="imp")
邊際圖:以散點圖呈現「Height」對「Weight」,任一變數有補值者以不同顏色標示。

在 R 中以插補處理遺漏值

平均值補值的問題

破壞變數關係:

  • HeightWeight 做平均值補值後,正相關變弱。
  • 以一者預測另一者的模型,會被離群的補值誤導而產生偏誤結果。

補值無變異:

  • 資料變異變小,所有標準誤會被低估。將影響假設檢定與信賴區間的可靠性。
在 R 中以插補處理遺漏值

中位數與眾數補值

  • 可用中位數或眾數替代平均數補值。
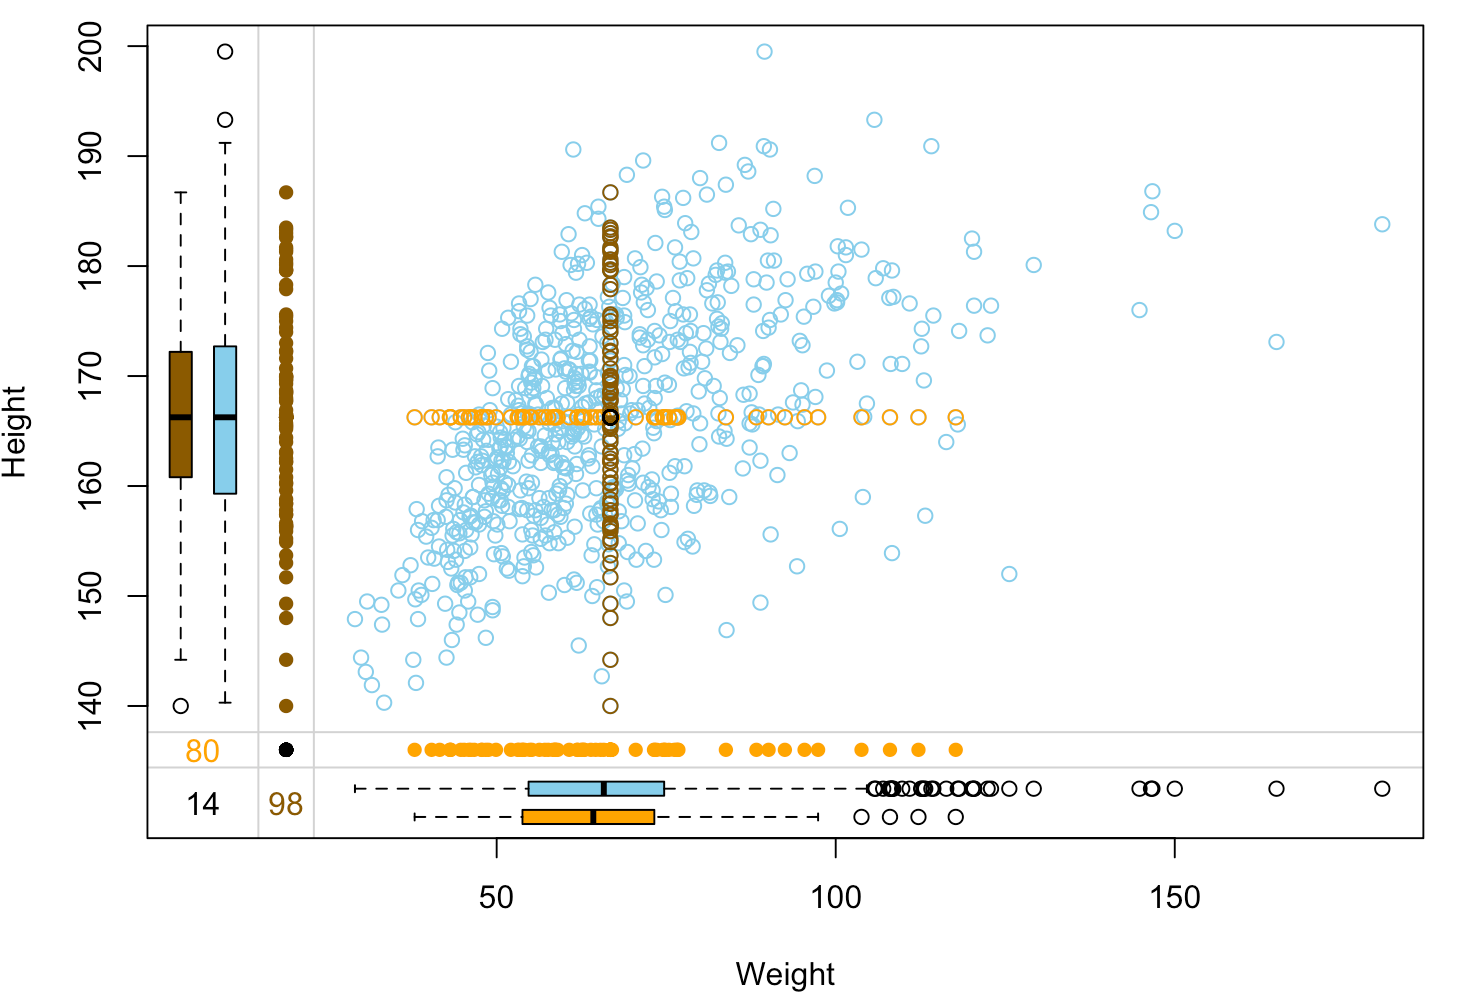
  • 當資料含離群值,中位數補值較佳。
  • 類別變數無法計算平均或中位數,因此改用眾數。
  • 中位數與眾數補值也有與平均值補值相同的缺點。

邊際圖:以散點圖呈現「Height」對「Weight」,任一變數有補值者以不同顏色標示。

在 R 中以插補處理遺漏值

一起來練習吧!

在 R 中以插補處理遺漏值

Preparing Video For Download...