k-Nearest-Neighbors 插補

在 R 中以插補處理遺漏值

Michal Oleszak

Machine Learning Engineer

k-Nearest-Neighbors 插補
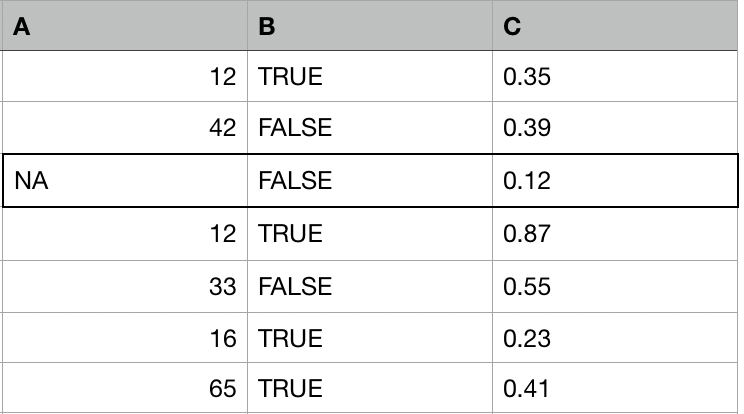
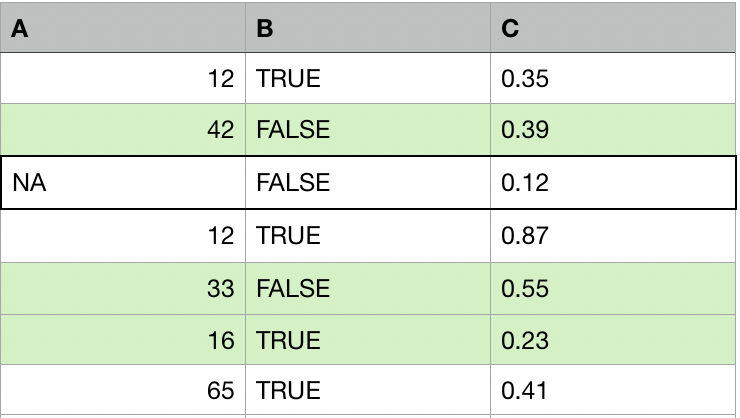
一個有三欄 A、B、C 的表格。A 欄有一個遺漏值。

在 R 中以插補處理遺漏值

k-Nearest-Neighbors 插補

一個有三欄 A、B、C 的表格。A 欄有一個遺漏值。三筆不含遺漏值的列以顏色標示。

對每筆含遺漏值的觀測:

  1. 找出與該觀測最相似的其他 k 筆觀測(捐贈者、鄰居)。
在 R 中以插補處理遺漏值

k-Nearest-Neighbors 插補

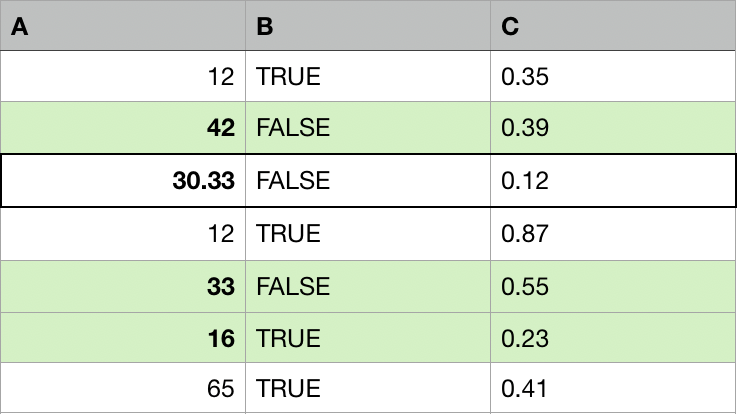
一個有三欄 A、B、C 的表格。三筆不含遺漏值的列以顏色標示。A 欄先前的遺漏值,已以標示列同欄數值的平均數取代。

對每筆含遺漏值的觀測:

  1. 找出與該觀測最相似的其他 k 筆觀測(捐贈者、鄰居)。
  2. 以這 k 位捐贈者的聚合值(平均數、中位數、眾數)取代遺漏值。
在 R 中以插補處理遺漏值

距離量測

兩筆觀測 ab 的距離:

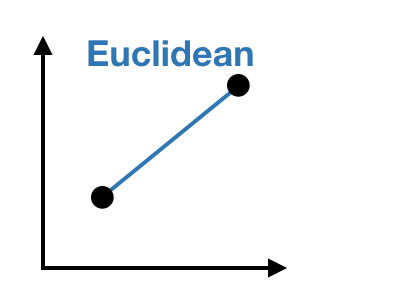
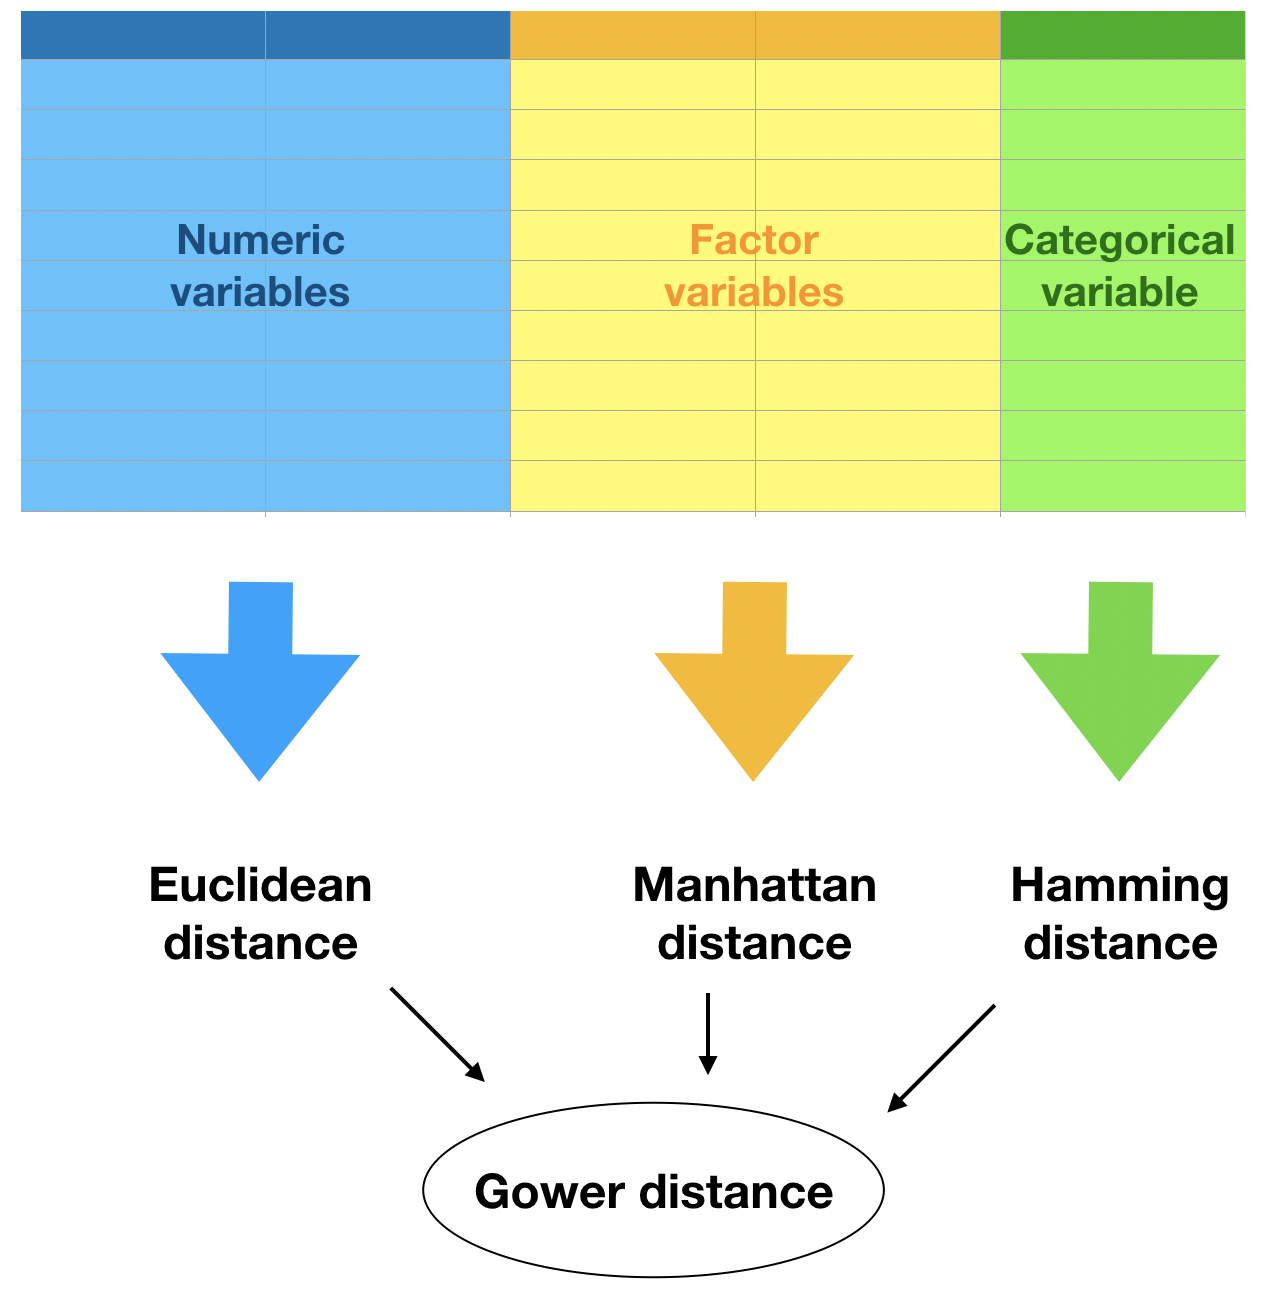
針對 n 個數值變數的「歐氏距離」:

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

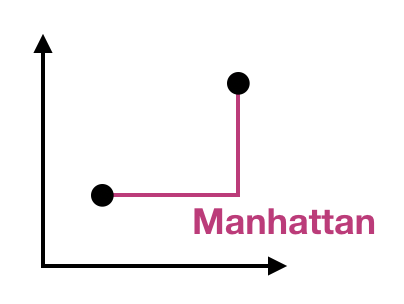
針對 f 個因子變數的「曼哈頓距離」:

$\Sigma_{i=1}^{f} |a_i - b_i|$

針對 c 個類別變數的「海明距離」:

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

座標系上兩點以一直線相連。

座標系上兩點以兩條互相垂直的線相連,如同矩形的對角。

在 R 中以插補處理遺漏值

Gower 距離

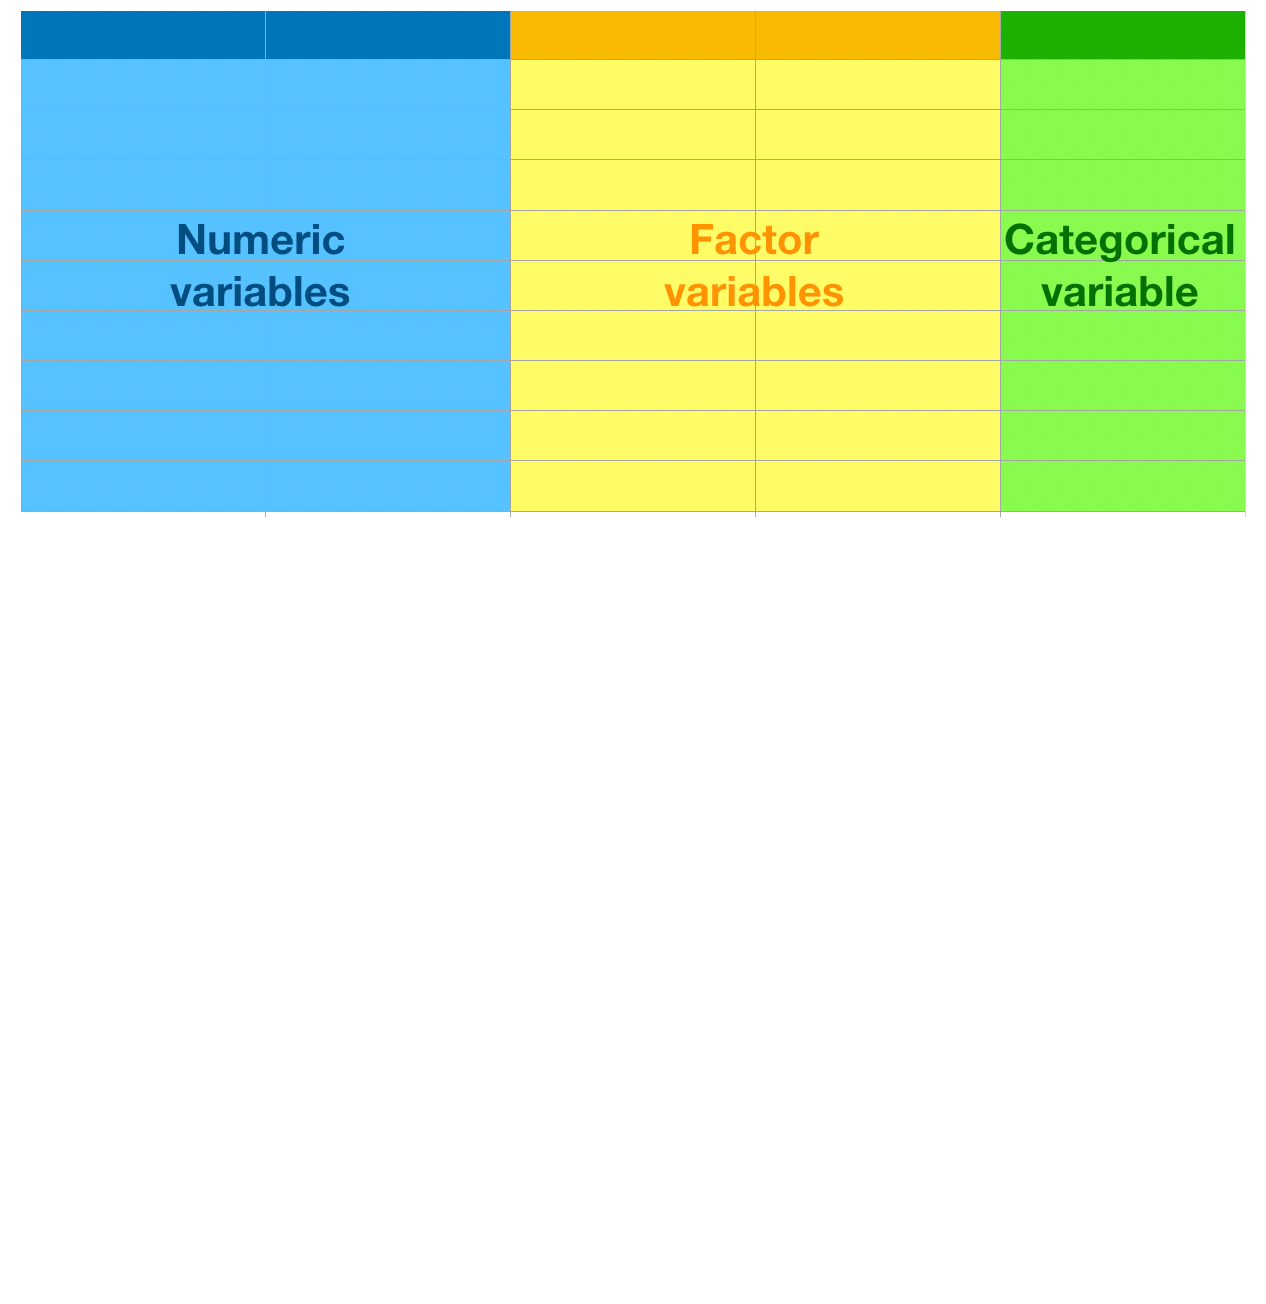
一個模擬的資料框,含三種變數型別,各以不同顏色標示:數值、因子與類別變數。

在 R 中以插補處理遺漏值

Gower 距離

一個模擬的資料框,含三種變數型別,各以不同顏色標示:數值、因子與類別變數。每種型別各有箭頭指向對應的距離量測:歐氏、曼哈頓與海明距離。三種距離合併為橢圓中的 Gower 距離。

在 R 中以插補處理遺漏值

實作 kNN 插補

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
在 R 中以插補處理遺漏值

捐贈者加權

  • 在為某筆觀測選的 k 位鄰居中,有的更相似。
  • 聚合其數值時,應對較近的鄰居給較高權重。
  • 以加權平均聚合鄰居,權重為各鄰居距離的倒數。
  • 只適用於插補數值變數。
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
在 R 中以插補處理遺漏值

變數排序

  • kNN 會逐一針對變數進行迴圈插補。
  • 每次都會重新計算觀測間的距離。
  • 若第一個變數有很多遺漏值,則第二個變數的距離計算會大量依賴已插補的值。
  • 執行 kNN 前,建議依遺漏值數量遞增排序變數。
在 R 中以插補處理遺漏值

實作變數排序

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
在 R 中以插補處理遺漏值

一起來練習吧!

在 R 中以插補處理遺漏值

Preparing Video For Download...