R 的詐欺偵測
Tim Verdonck
Professor Data Science at KU Leuven
目標
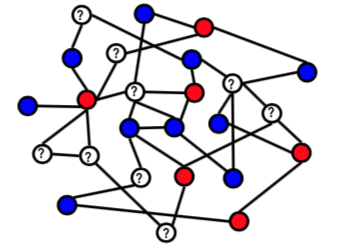
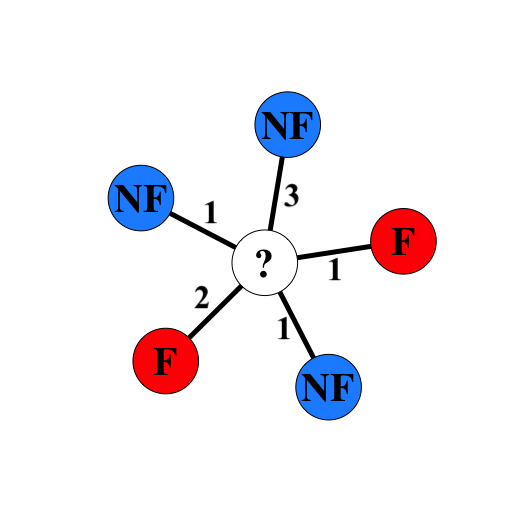
根據其他節點的行為來預測某節點的行為
挑戰
非關聯式模型
關聯式模型
假設
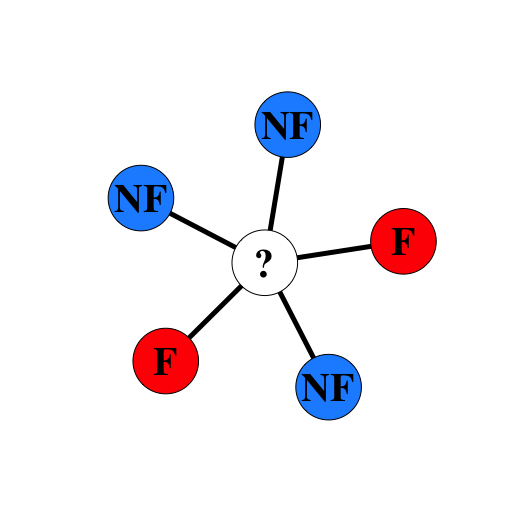
詐欺機率
$$P(F | ?) = \frac{1 + 1}{1 + 1 + 1 + 1 + 1}=\frac{2}{5}= 40\%$$
$$P(F | ?) = \frac{1 + 2}{3 + 1 + 1 + 2 + 1}=\frac{3}{8}=37.5\%$$
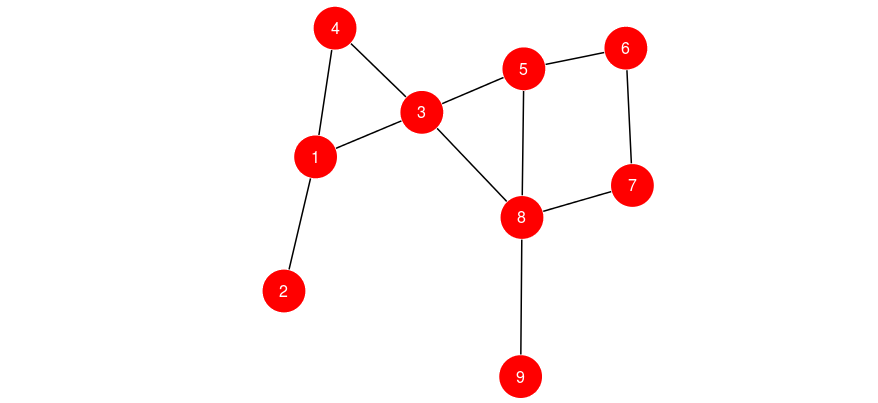
vertex_attr(network) ## 節點標記為 1(詐欺)、0(非詐欺),或 NA(未知)
$name
"?" "B" "C" "D" "E" "A"
$isFraud
NA 1 0 1 0 0
edge_attr(network) ## 邊具有權重

$weight
edge_attr(network) ## 邊具有權重
$weight
2 3 1 1 1
## subgraph():建立只含節點 "?" 與所有詐欺節點的子圖
subnetwork <- subgraph(network, v = c("?", "B", "D"))

## strength():計算節點 "?" 鄰接邊的權重總和
prob_fraud <- strength(subnetwork, v = "?") / strength(network, v = "?")

prob_fraud
## subgraph():建立只含節點 "?" 與所有詐欺節點的子圖 subnetwork <- subgraph(network, v = c("?", "B", "D"))
## strength():計算節點 "?" 鄰接邊的權重總和 prob_fraud <- strength(subnetwork, v = "?") / strength(network, v = "?")
prob_fraud
0.375