課程導論與動機
R 的詐欺偵測

Bart Baesens
Professor Data Science at KU Leuven
授課講師
授課講師
授課講師
什麼是詐欺?
詐欺是種不常見、深思熟慮、難以察覺、會隨時間演變,且常經過縝密組織的犯罪,形式多樣。
成功詐欺分析模型的關鍵特性
成功詐欺分析模型的關鍵特性
成功詐欺分析模型的關鍵特性
成功詐欺分析模型的關鍵特性
成功詐欺分析模型的關鍵特性
詐欺偵測模型的挑戰
詐欺偵測模型的挑戰
詐欺偵測模型的挑戰
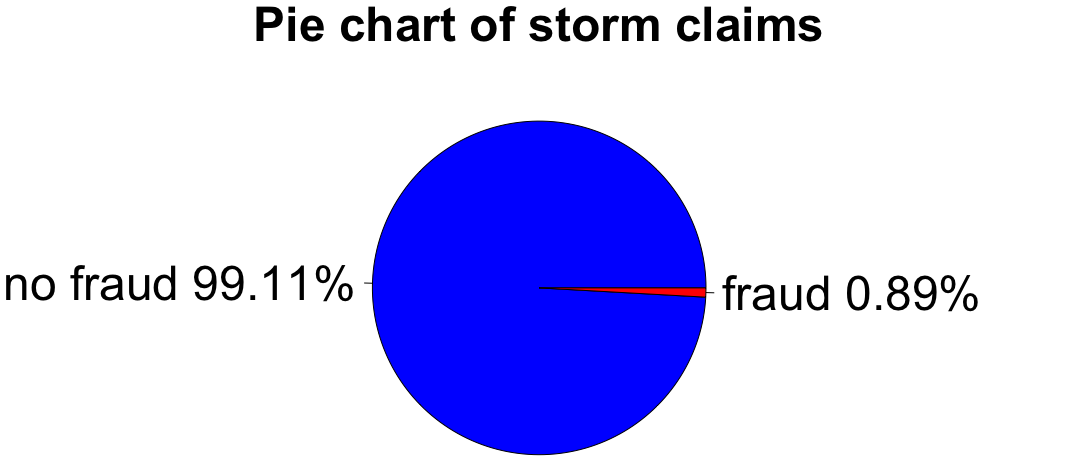
用圓餅圖呈現不平衡
labels <- c("no fraud", "fraud")
labels <- paste(labels, round(100 * prop.table(table(fraud_label)), 2), "%")
pie(table(fraud_label), labels, col = c("blue", "red"),
      main = "Pie chart of storm claims")
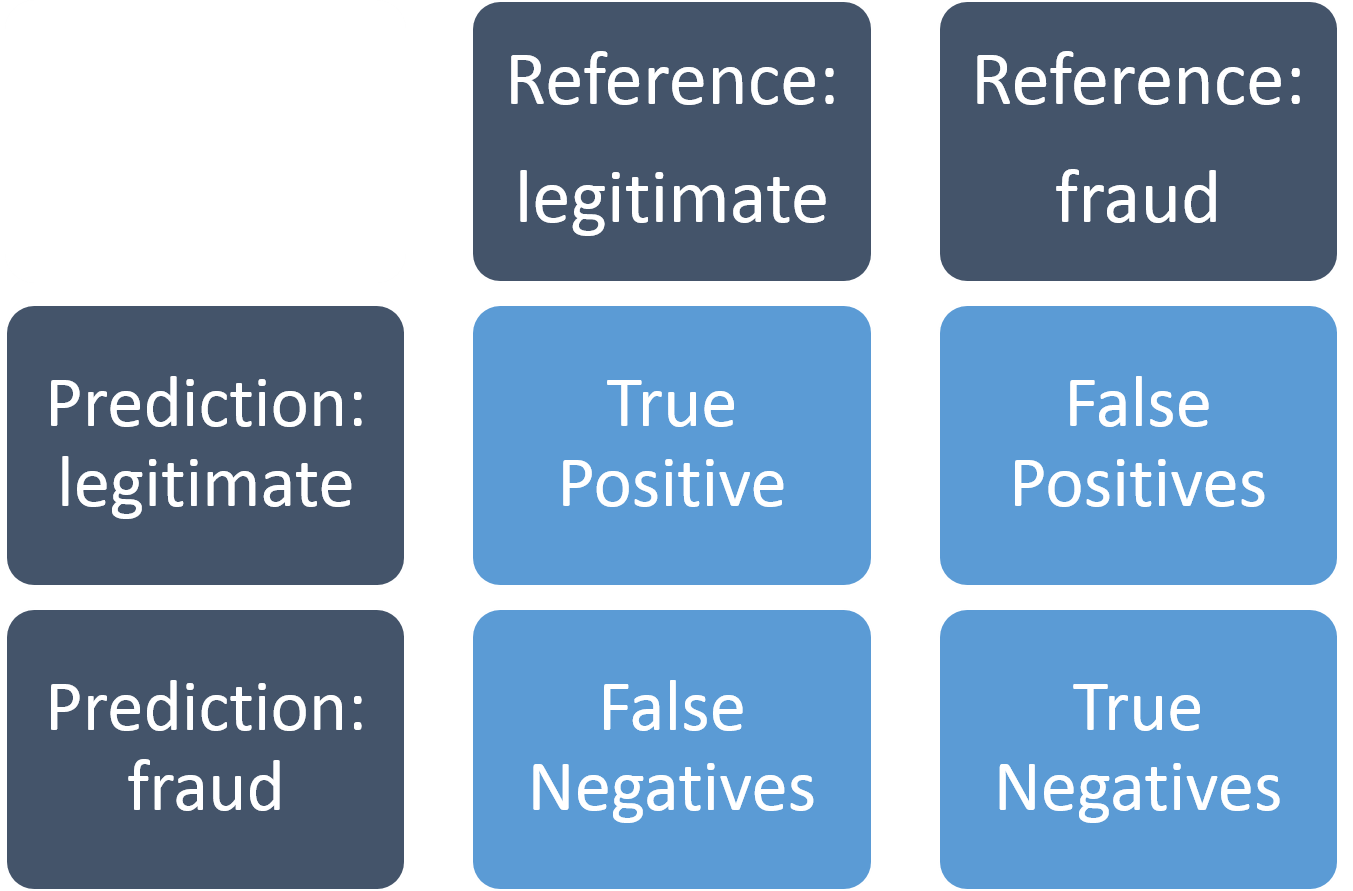
混淆矩陣
用於評估詐欺偵測模型: