合成過度取樣

R 的詐欺偵測

Sebastiaan Höppner

PhD researcher in Data Science at KU Leuven
使用「SMOTE」進行過度取樣

  • SMOTESynthetic Minority Oversampling TEchnique (Chawla 等,2002)
  • 以合成少數類樣本來對少數類(= 詐欺)進行過度取樣
R 的詐欺偵測
dim(transfer_data)
1000    4
head(transfer_data)
  isFraud    amount   balance     ratio
1   false  528.6840 1529.4732 0.3456641
2   false  184.0193  836.3509 0.2200265
3   false 1885.8024 2984.0684 0.6319568
4   false  732.0286 1248.7217 0.5862224
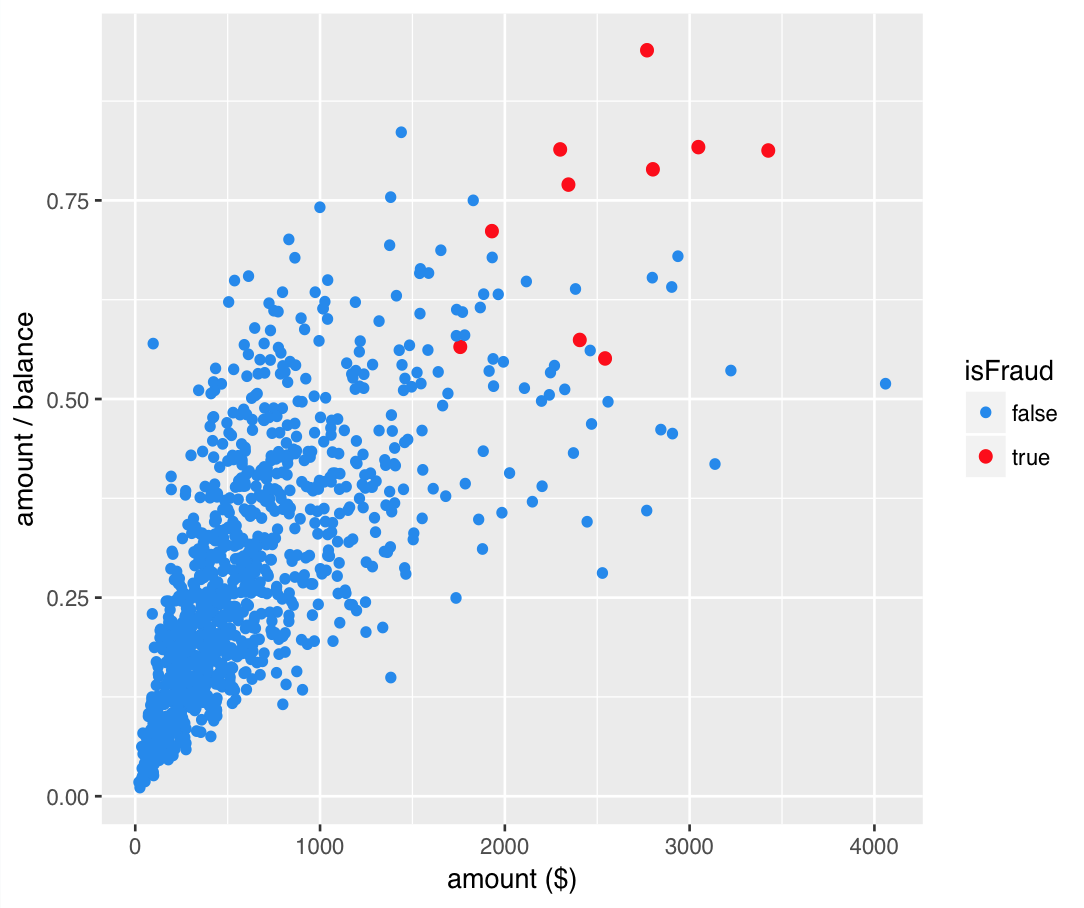
prop.table(table(transfer_data$isFraud))
 false  true
  0.99  0.01
R 的詐欺偵測

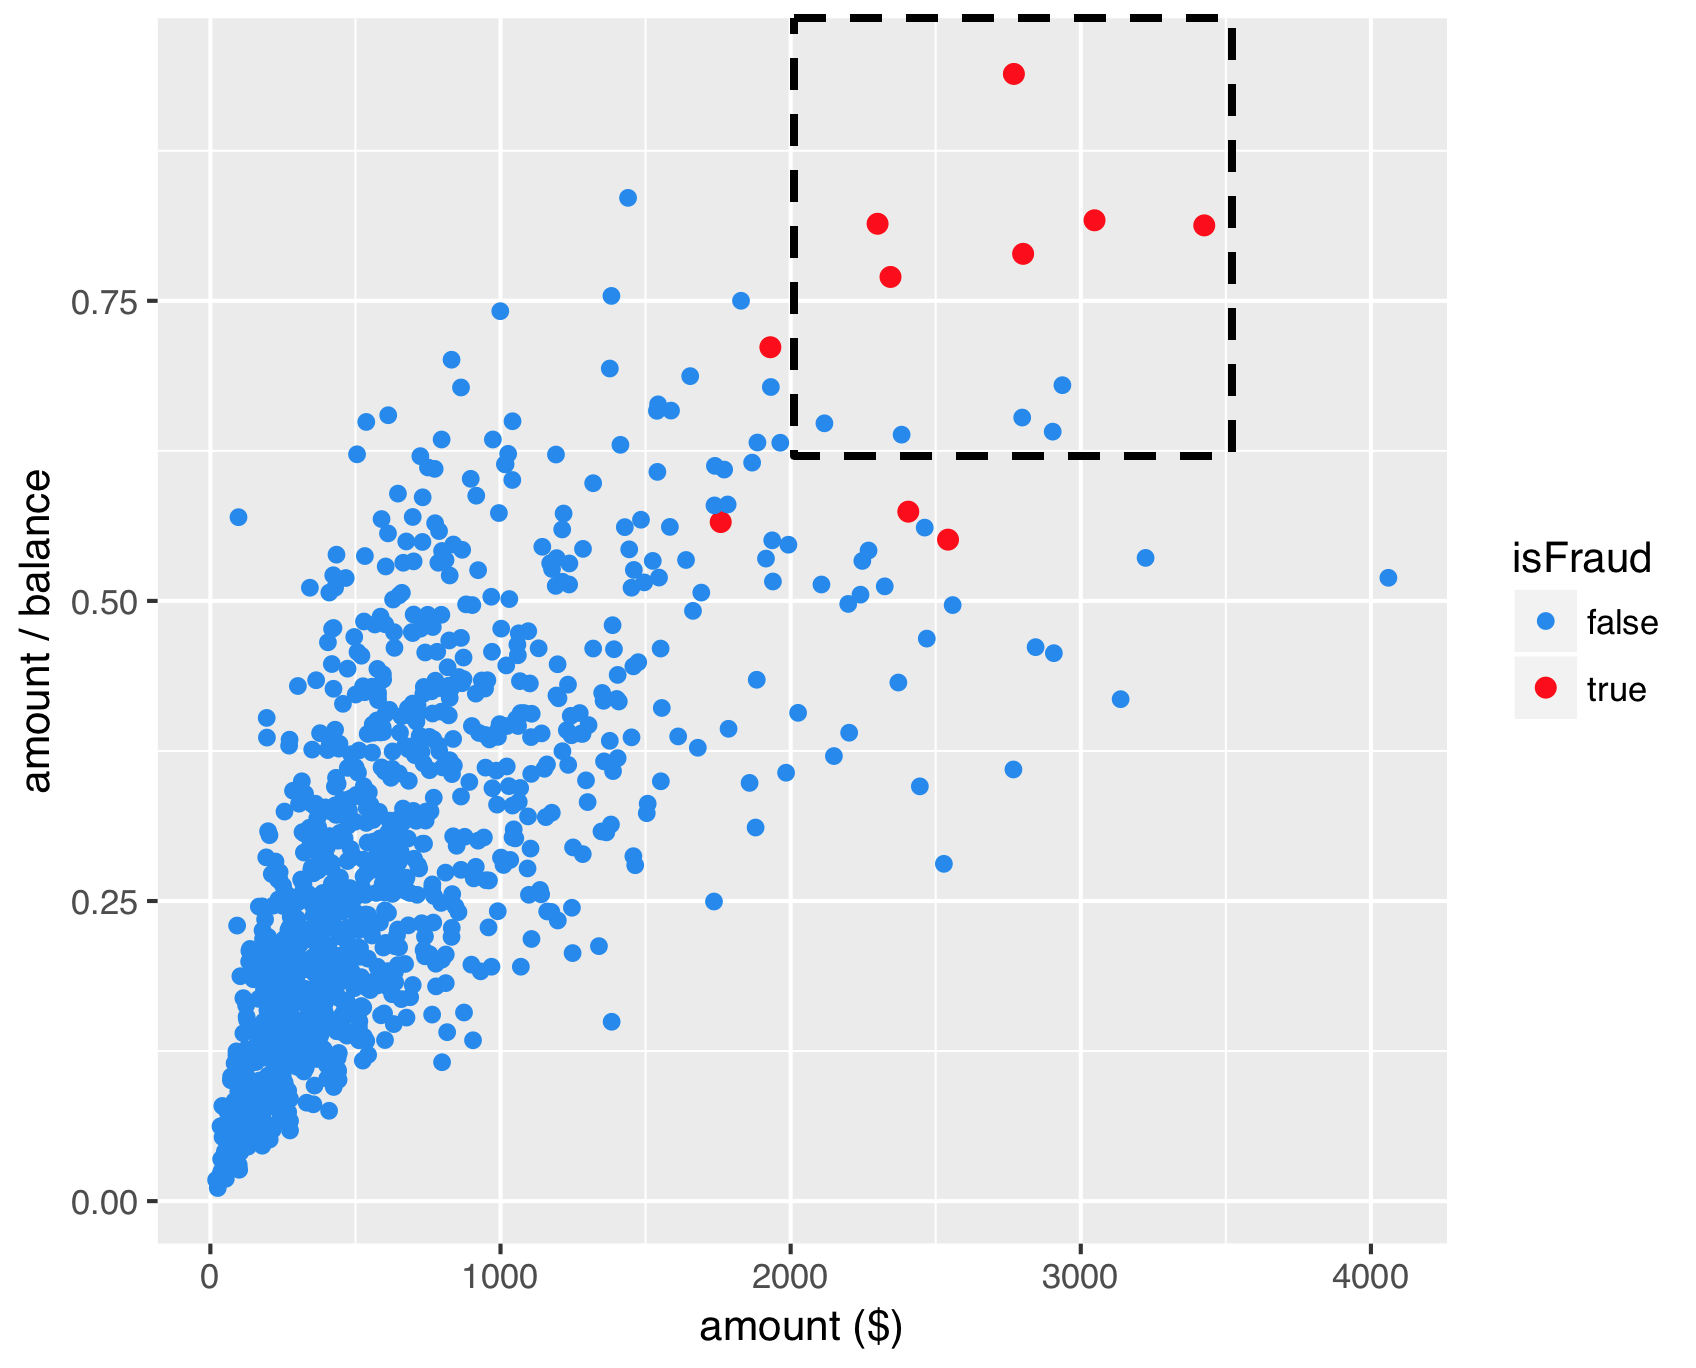
smote_scatterplot_1

R 的詐欺偵測

smote_scatterplot_2

R 的詐欺偵測

SMOTE

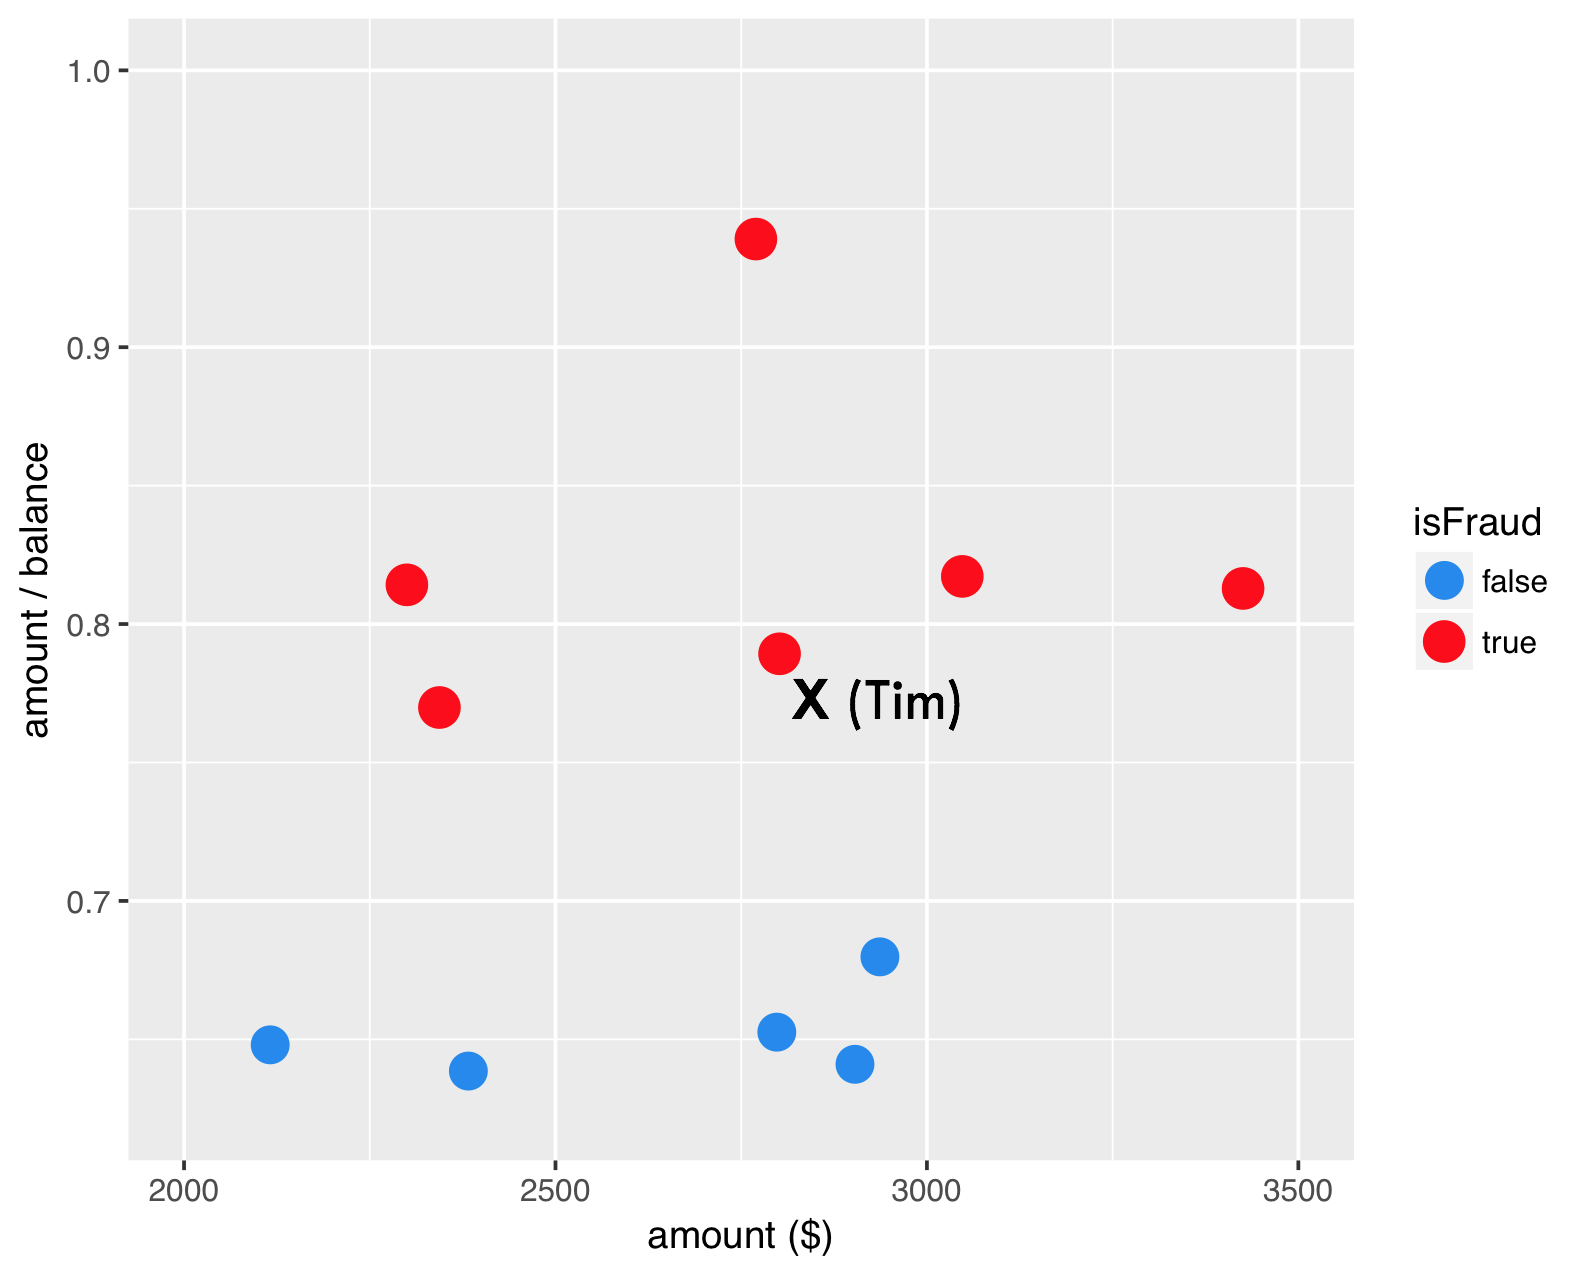
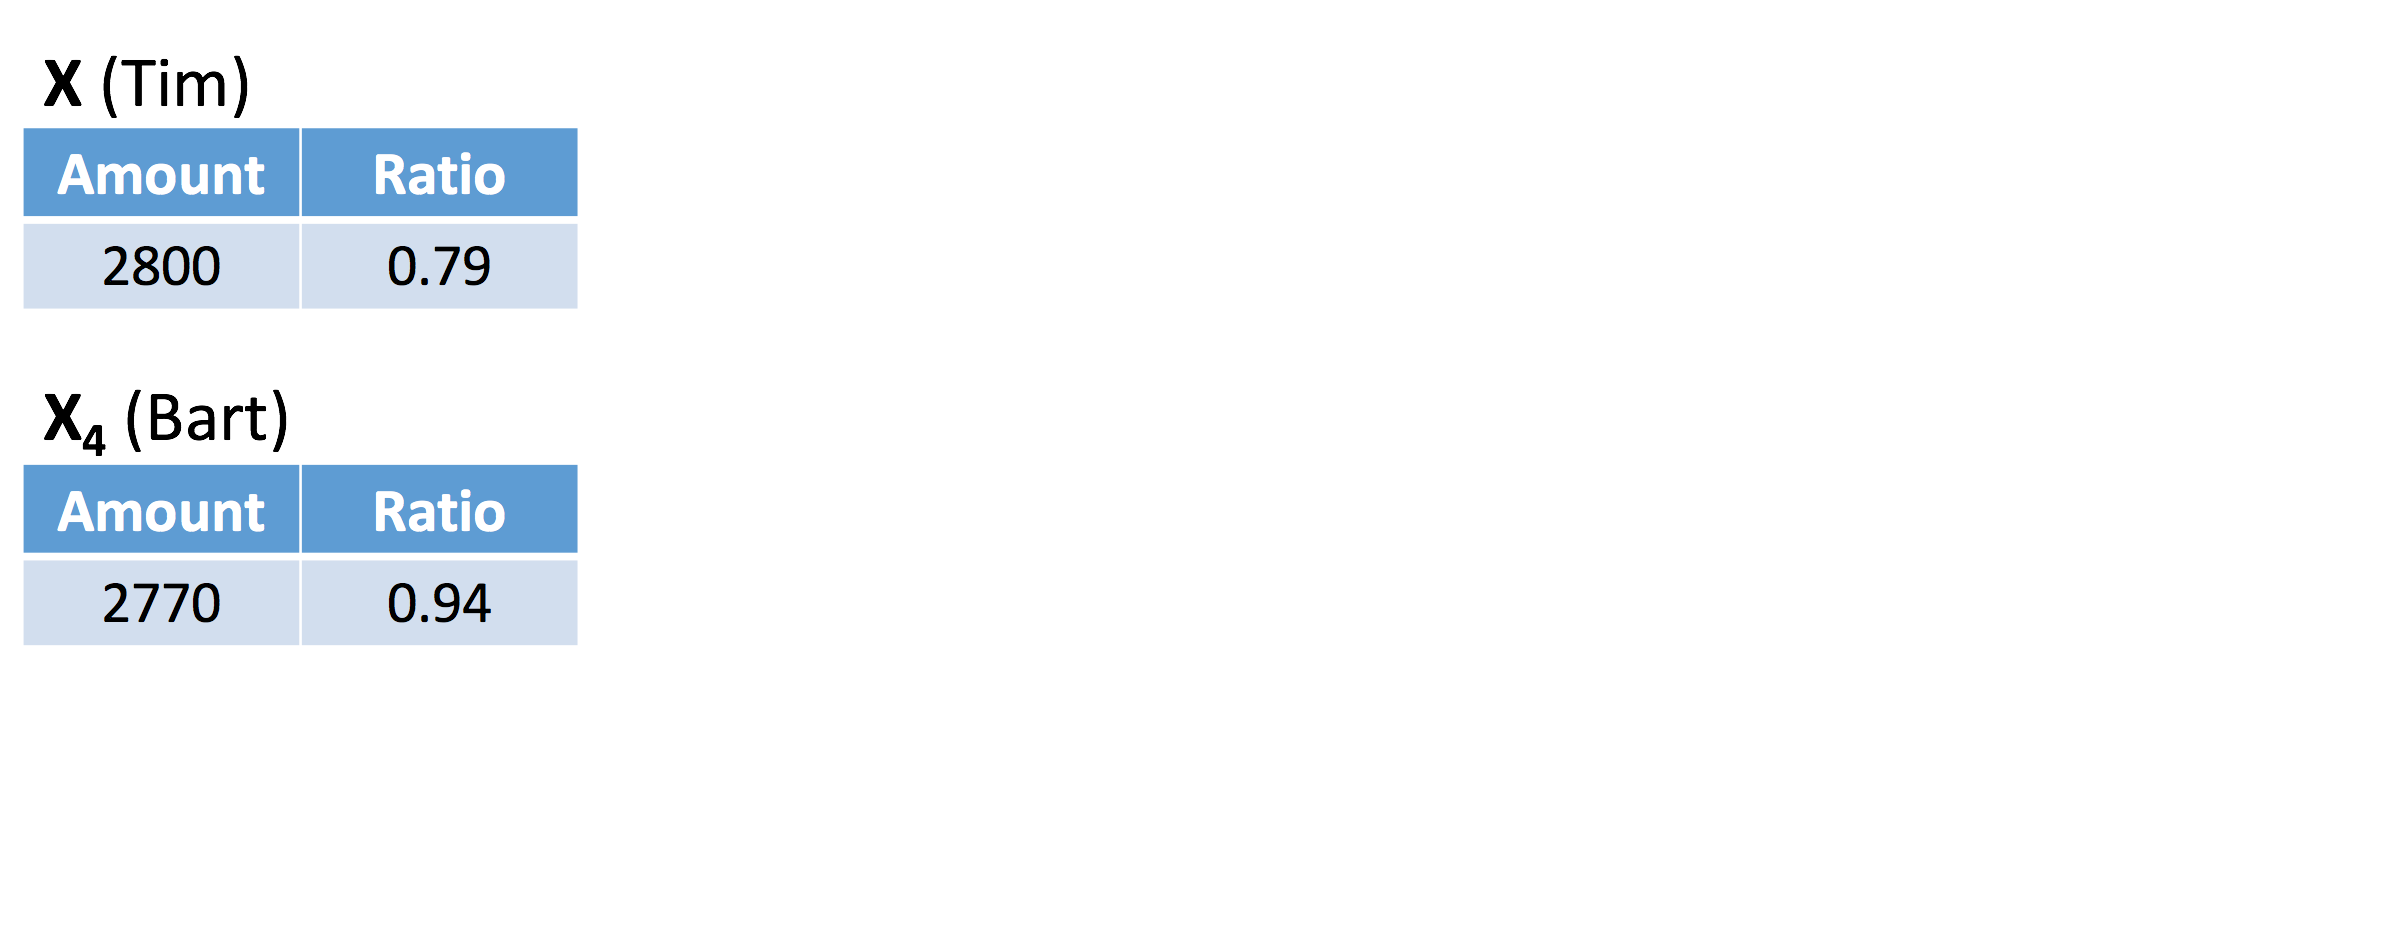
選一筆詐欺樣本 X(Tim)。

smote_zoomin

R 的詐欺偵測

SMOTE - 步驟 1

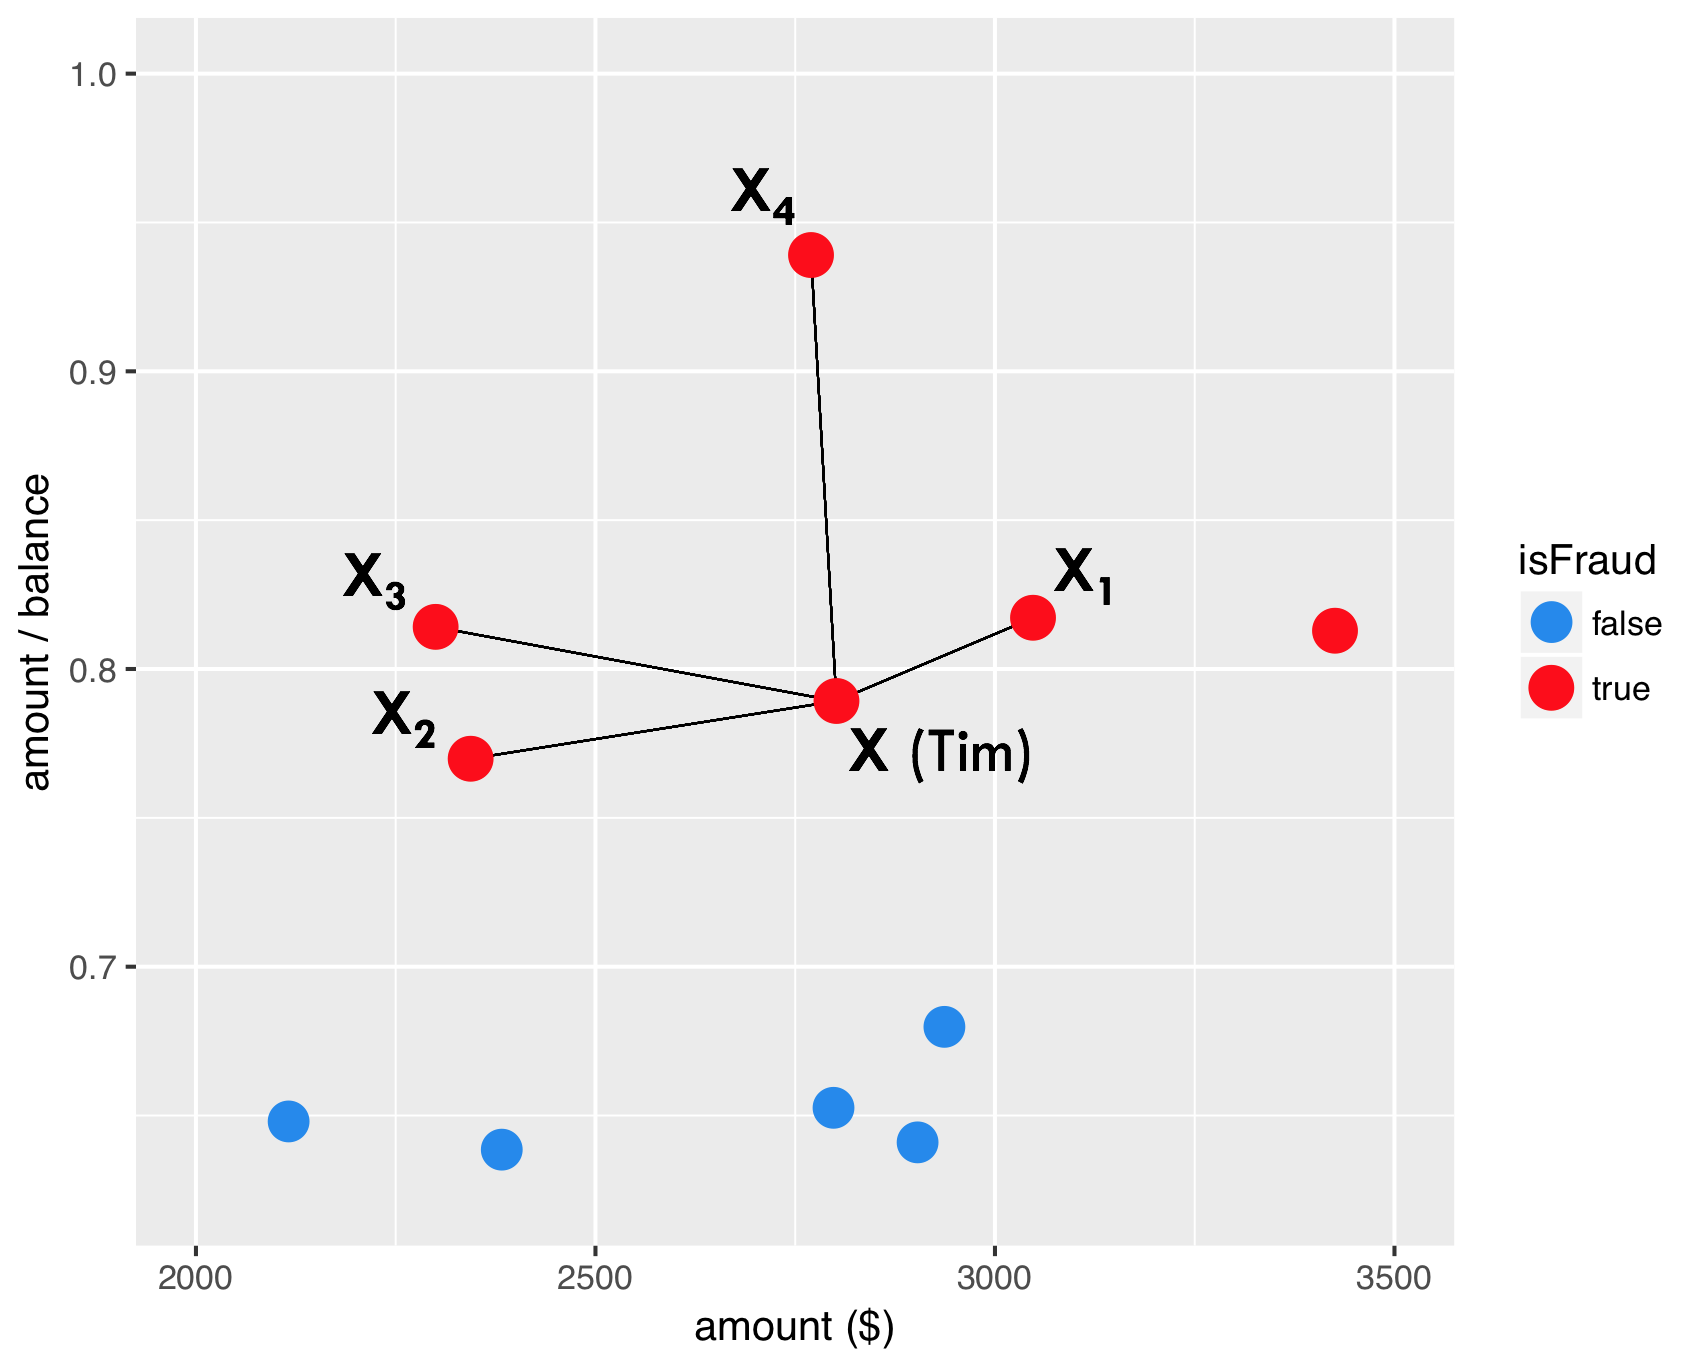
步驟 1

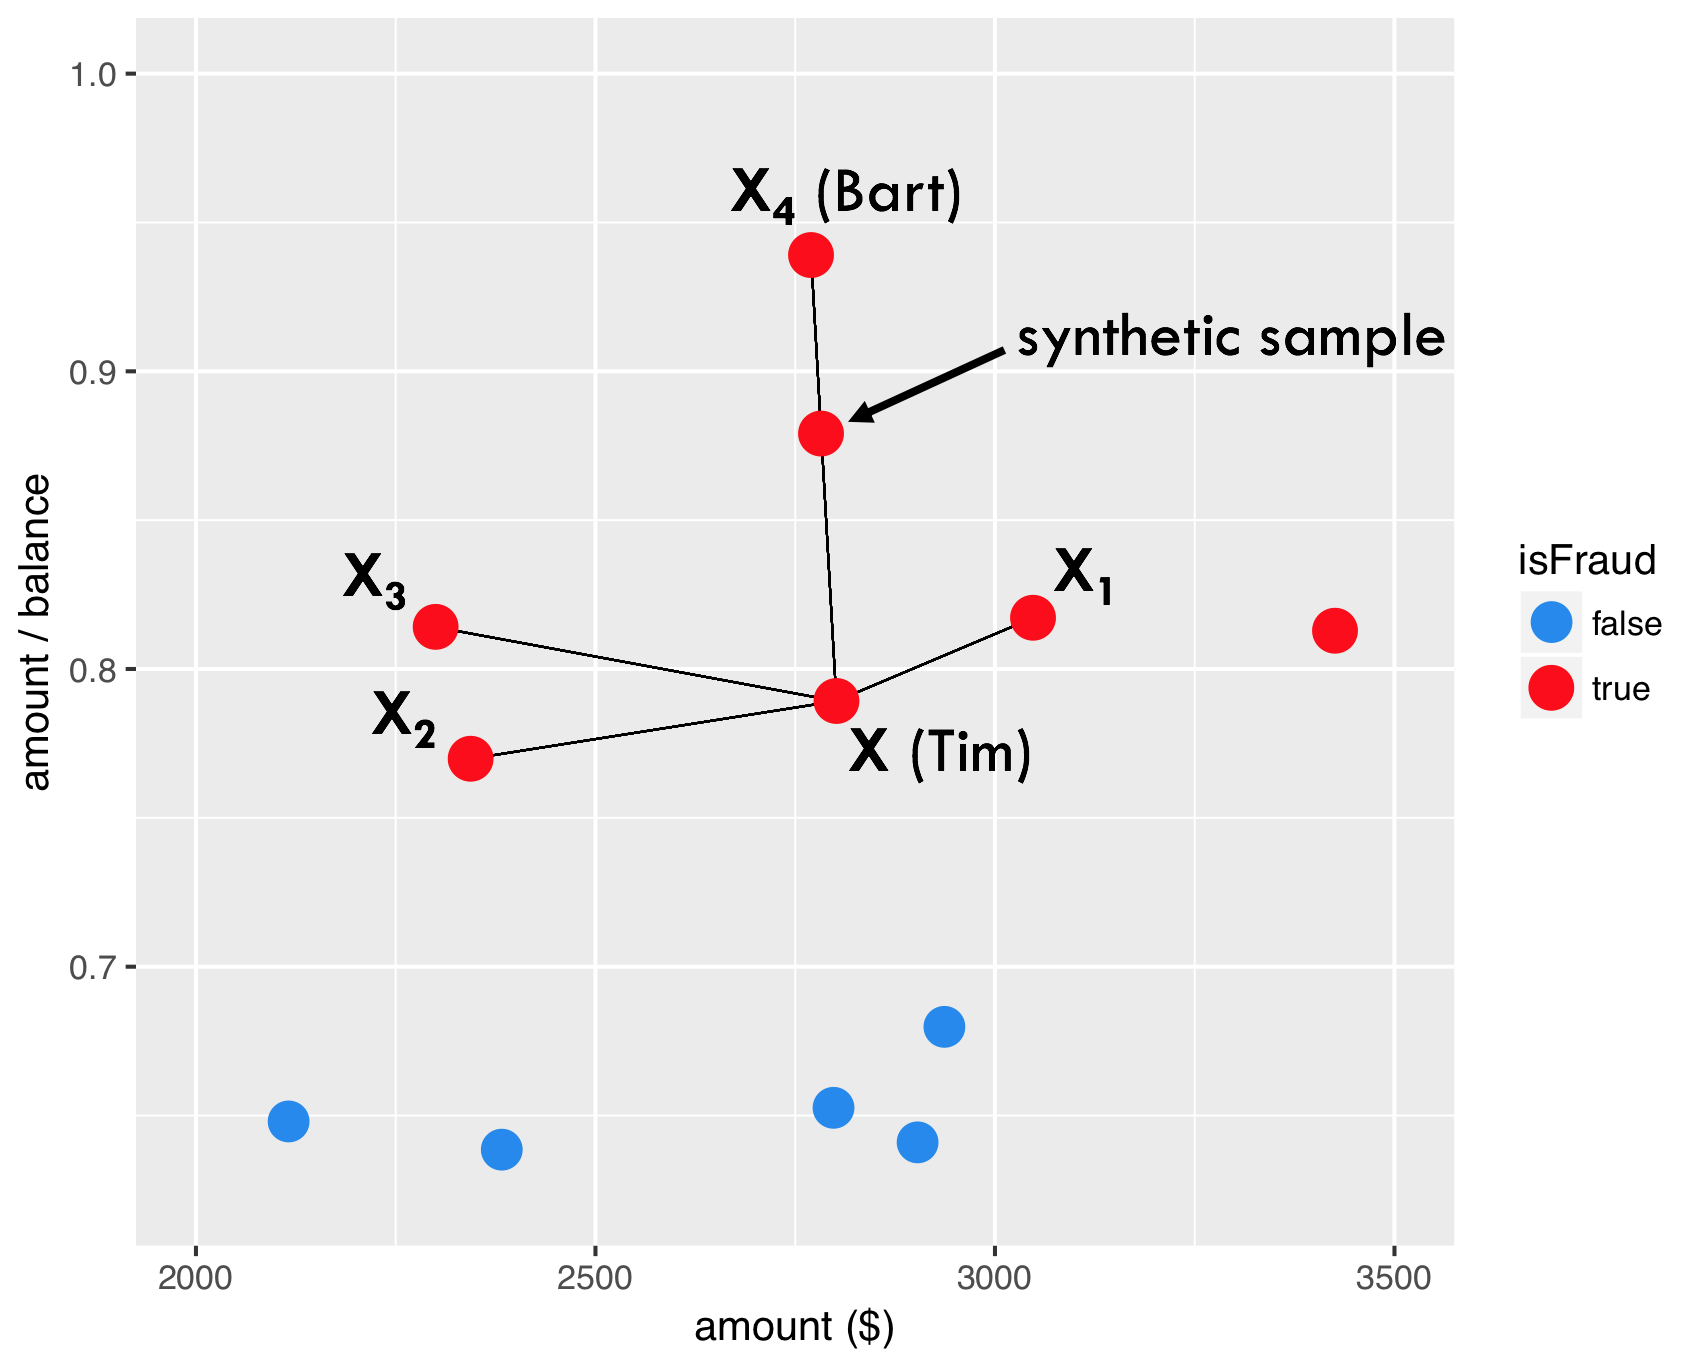
找出 X(Tim)的 K 個最近詐欺鄰居。 例如 K = 4

smote_step1

R 的詐欺偵測

SMOTE - 步驟 2

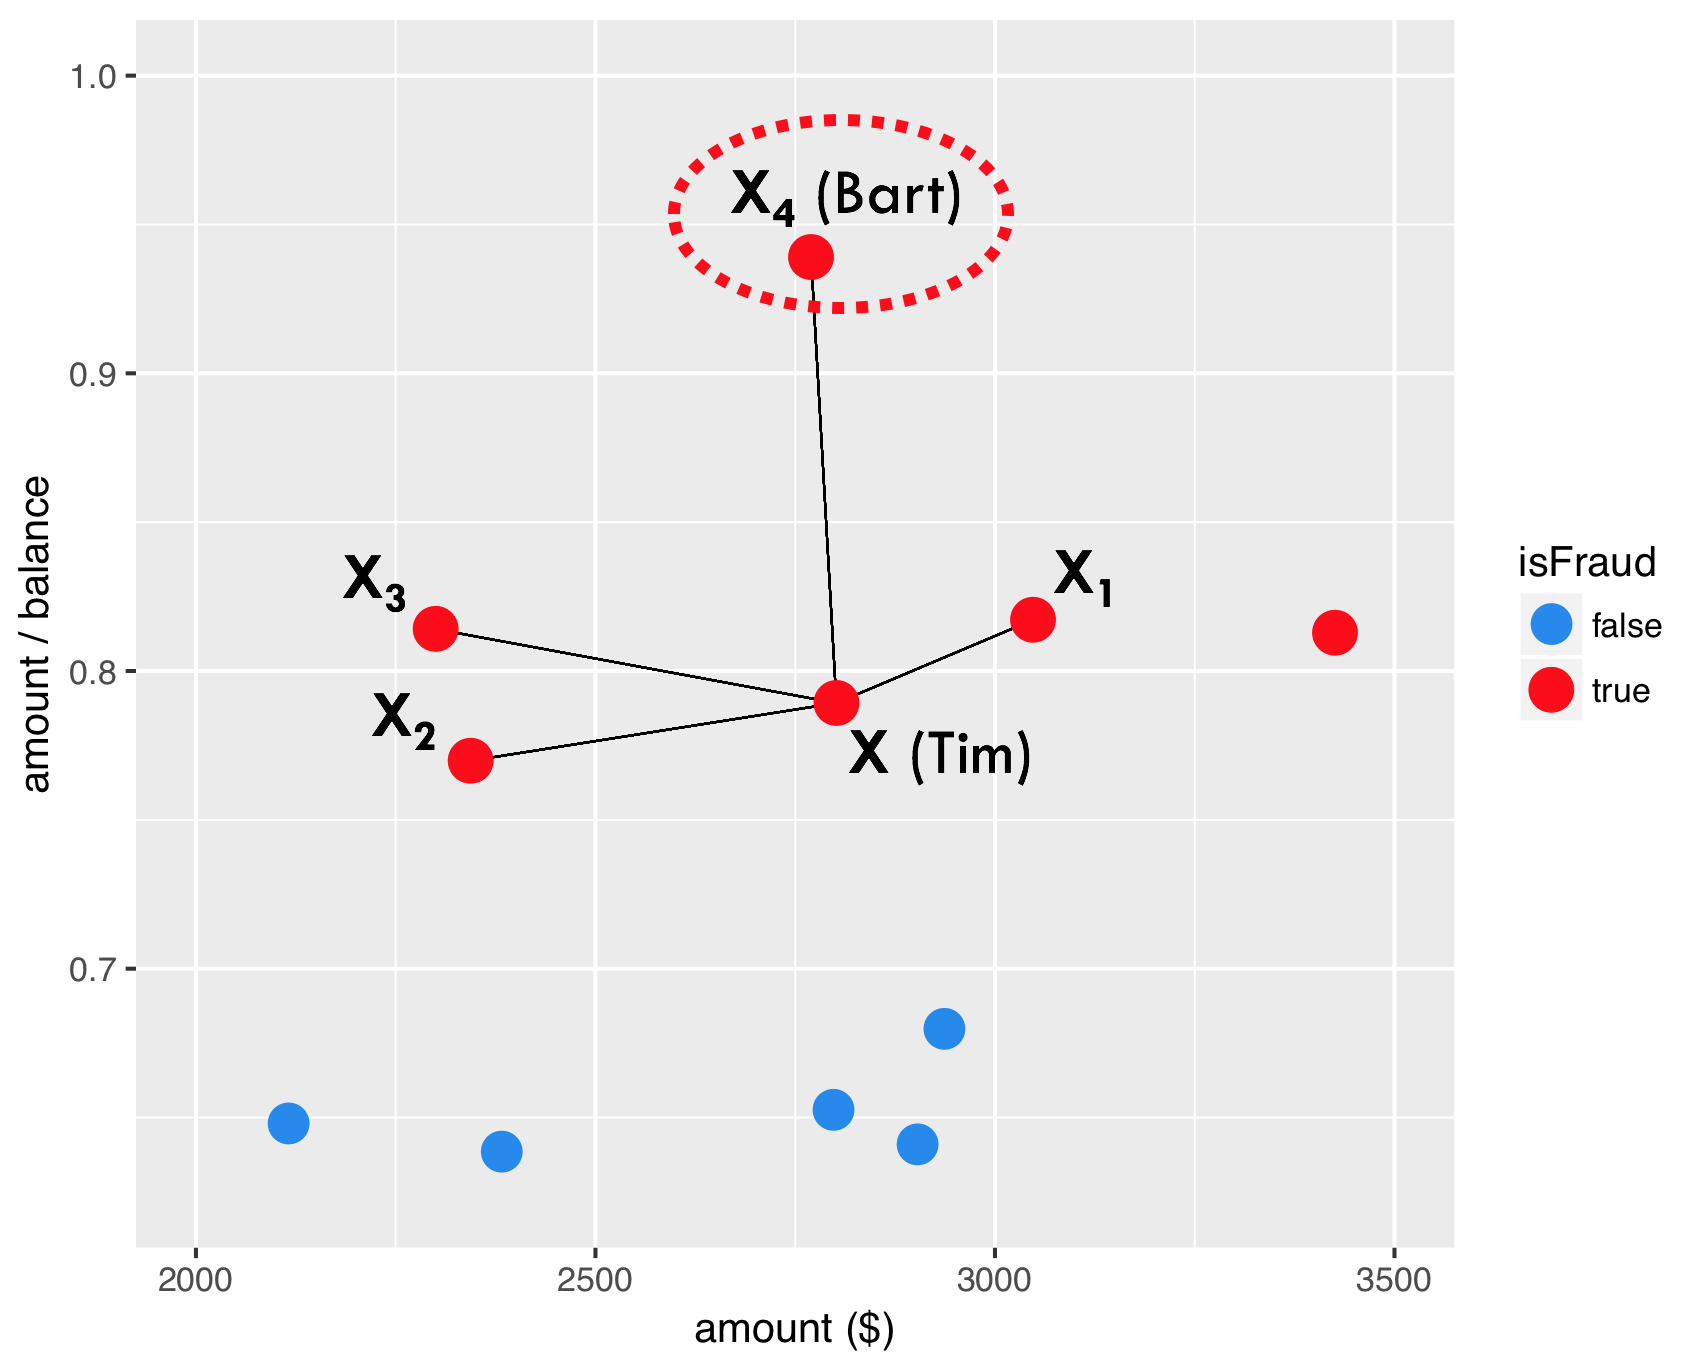
步驟 2

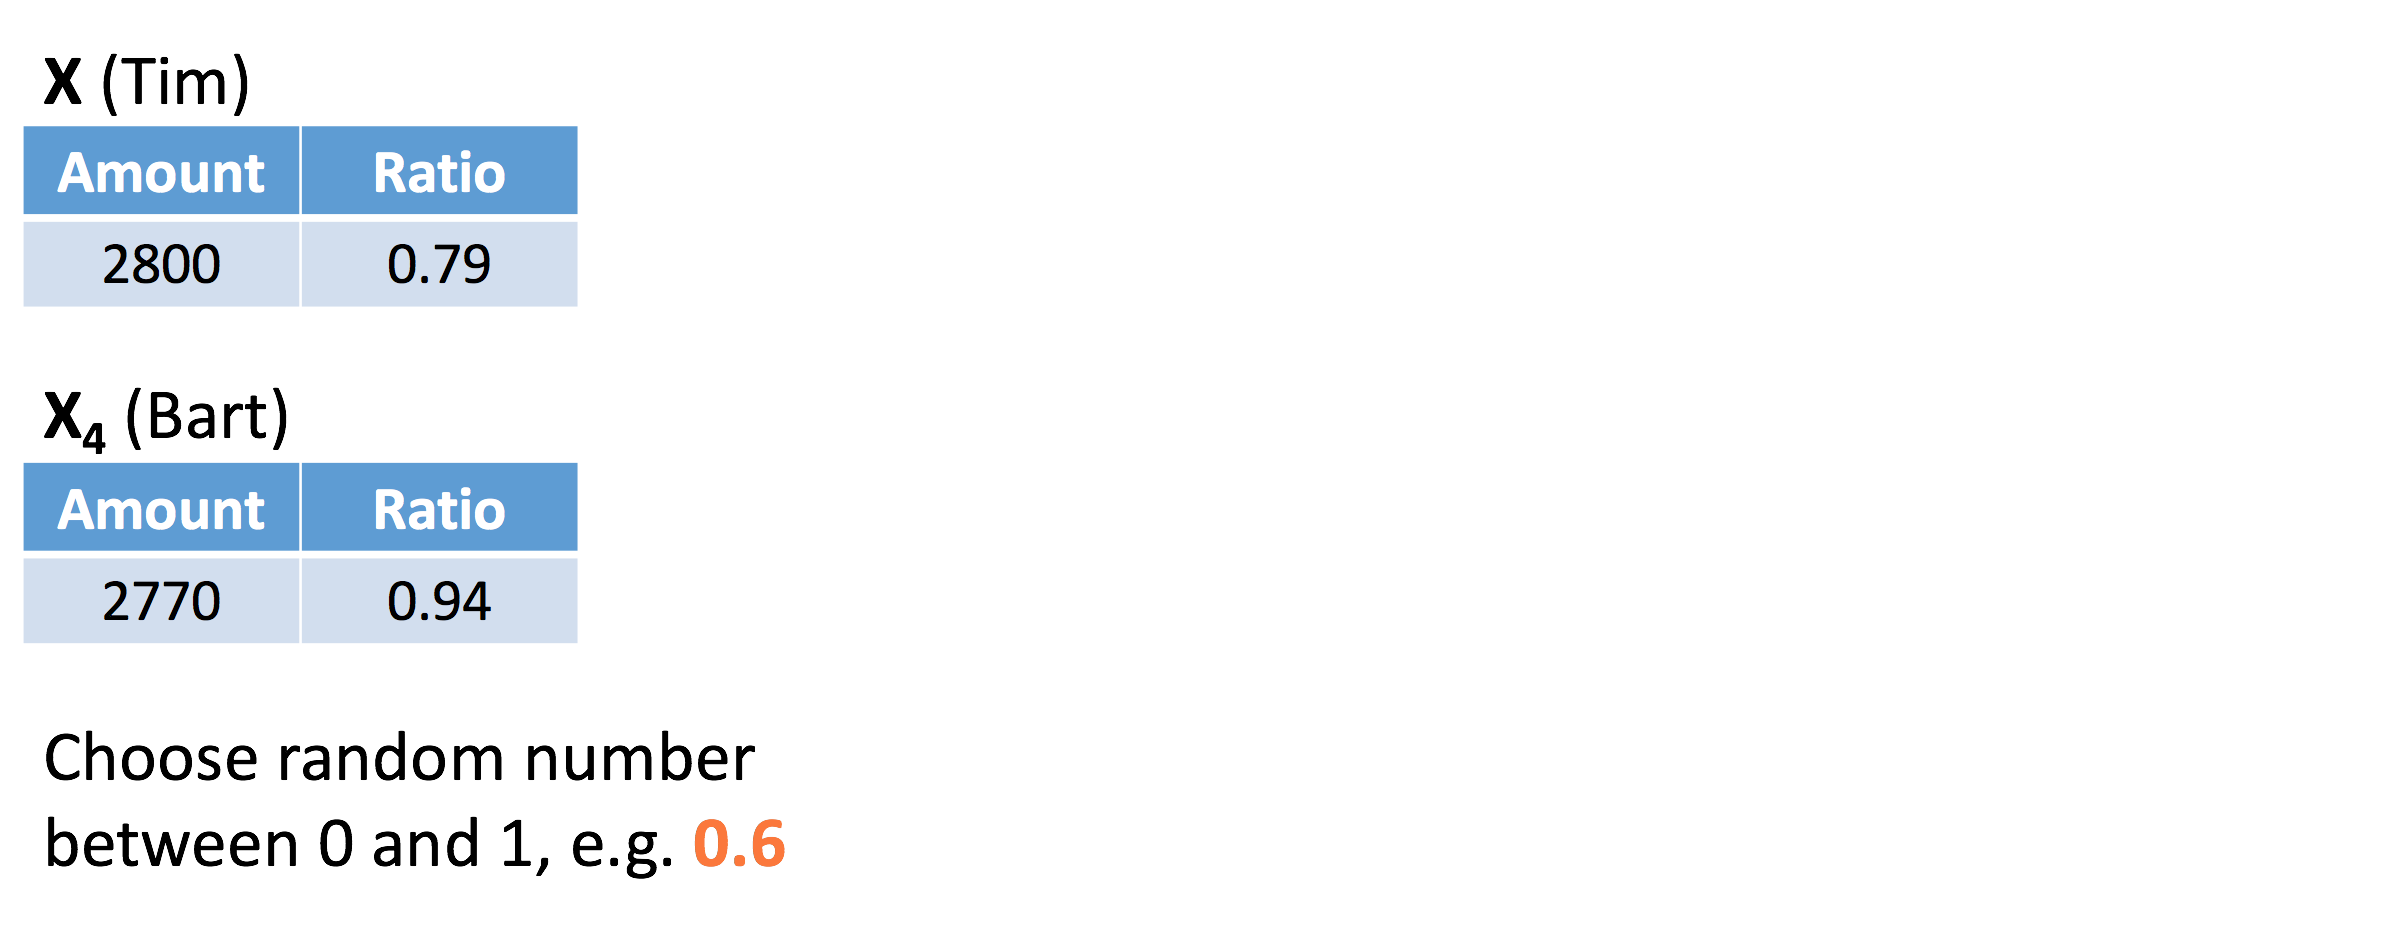
隨機選一個 Tim 的最近鄰。 例如 X4(Bart)

smote_step2

R 的詐欺偵測

SMOTE - 步驟 3

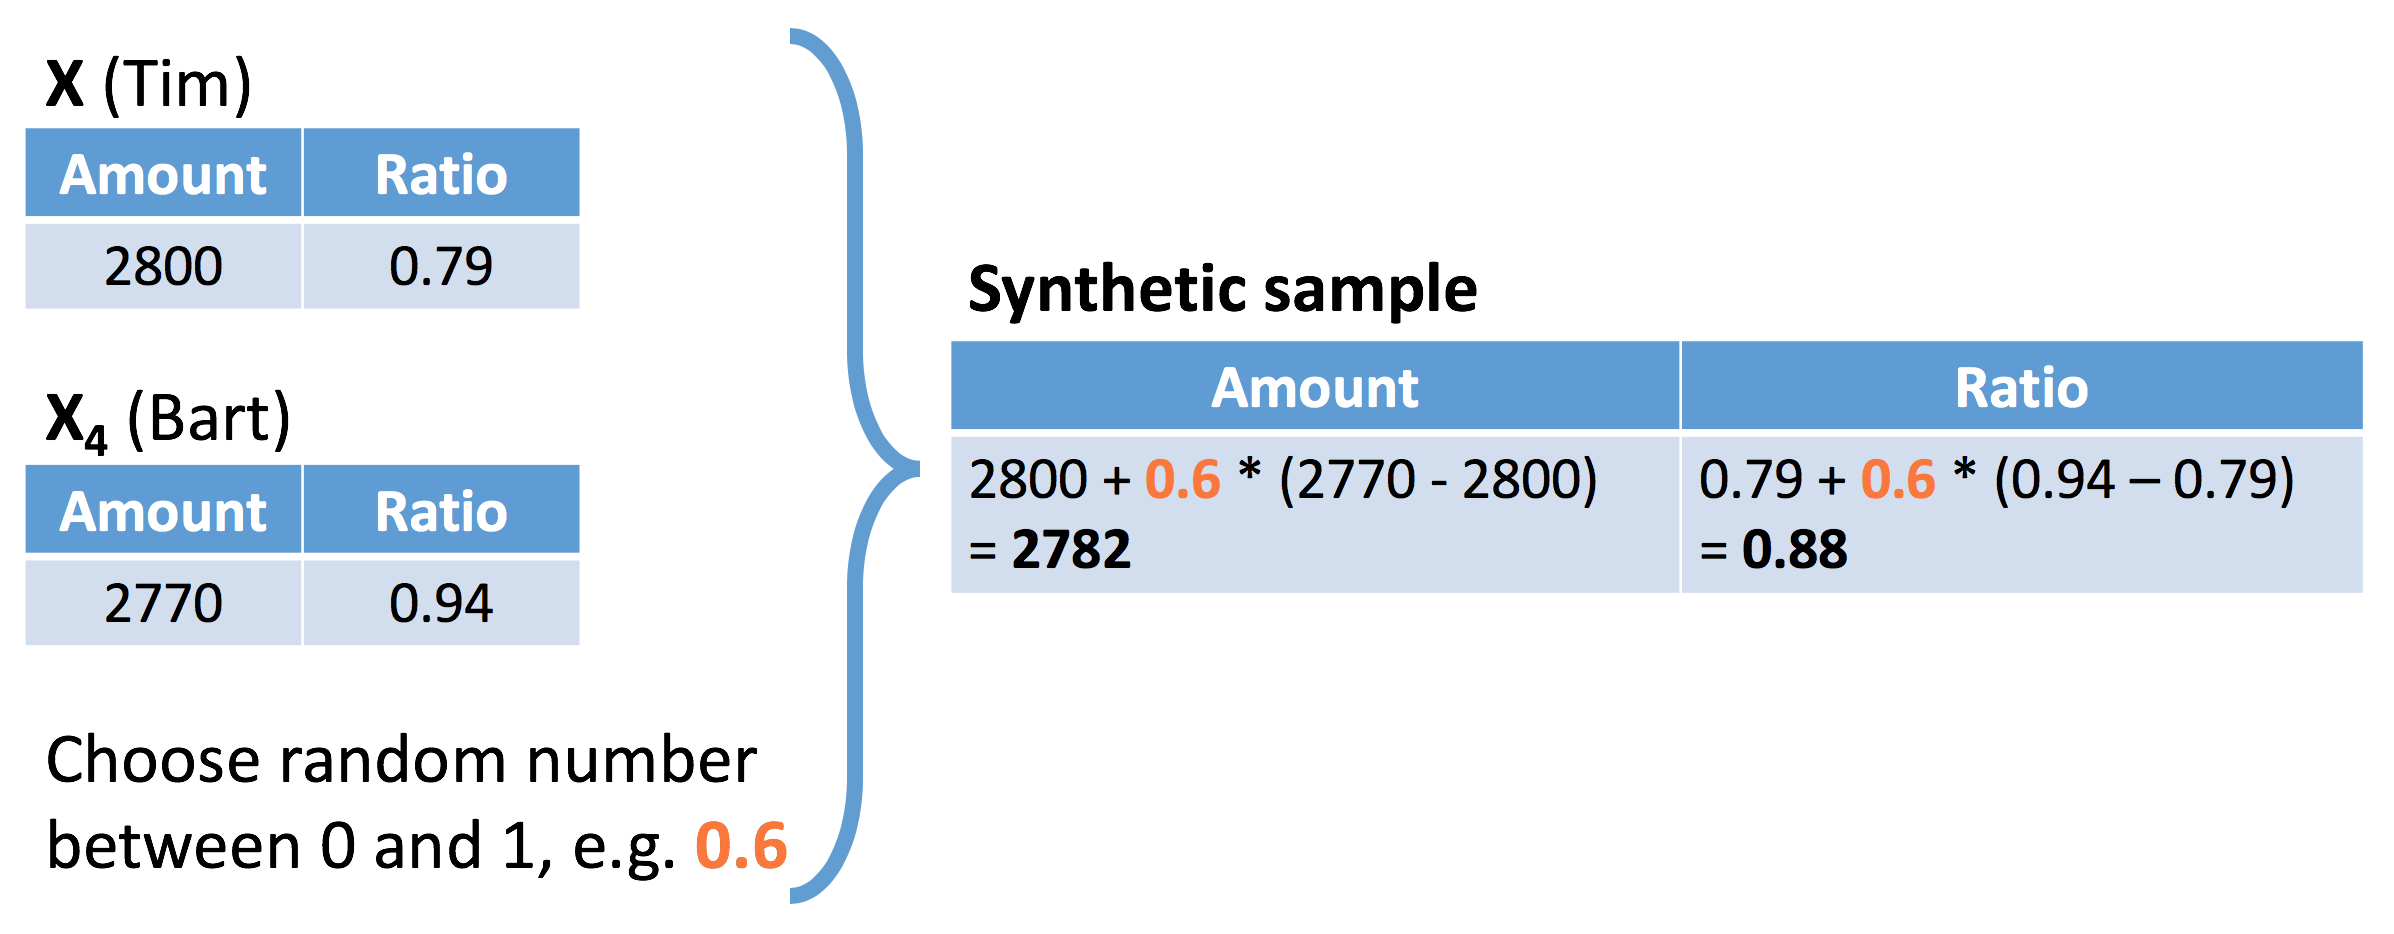
步驟 3:建立合成樣本

synthetic_case_1

R 的詐欺偵測

SMOTE - 步驟 3

步驟 3:建立合成樣本

synthetic_case_2

R 的詐欺偵測

SMOTE - 步驟 3

步驟 3:建立合成樣本

synthetic_case_3

R 的詐欺偵測

SMOTE - 步驟 3

smote_step3

R 的詐欺偵測

SMOTE - 步驟 4

步驟 4

對每筆詐欺樣本重複步驟 1–3,共 dup_size 次。 例如 dup_size = 10

smote_step3

R 的詐欺偵測
library(smotefamily)
smote_output = SMOTE(X = transfer_data[, -1],
                       target = transfer_data$isFraud,
                       K = 4,
                       dup_size = 10)

oversampled_data = smote_output$data
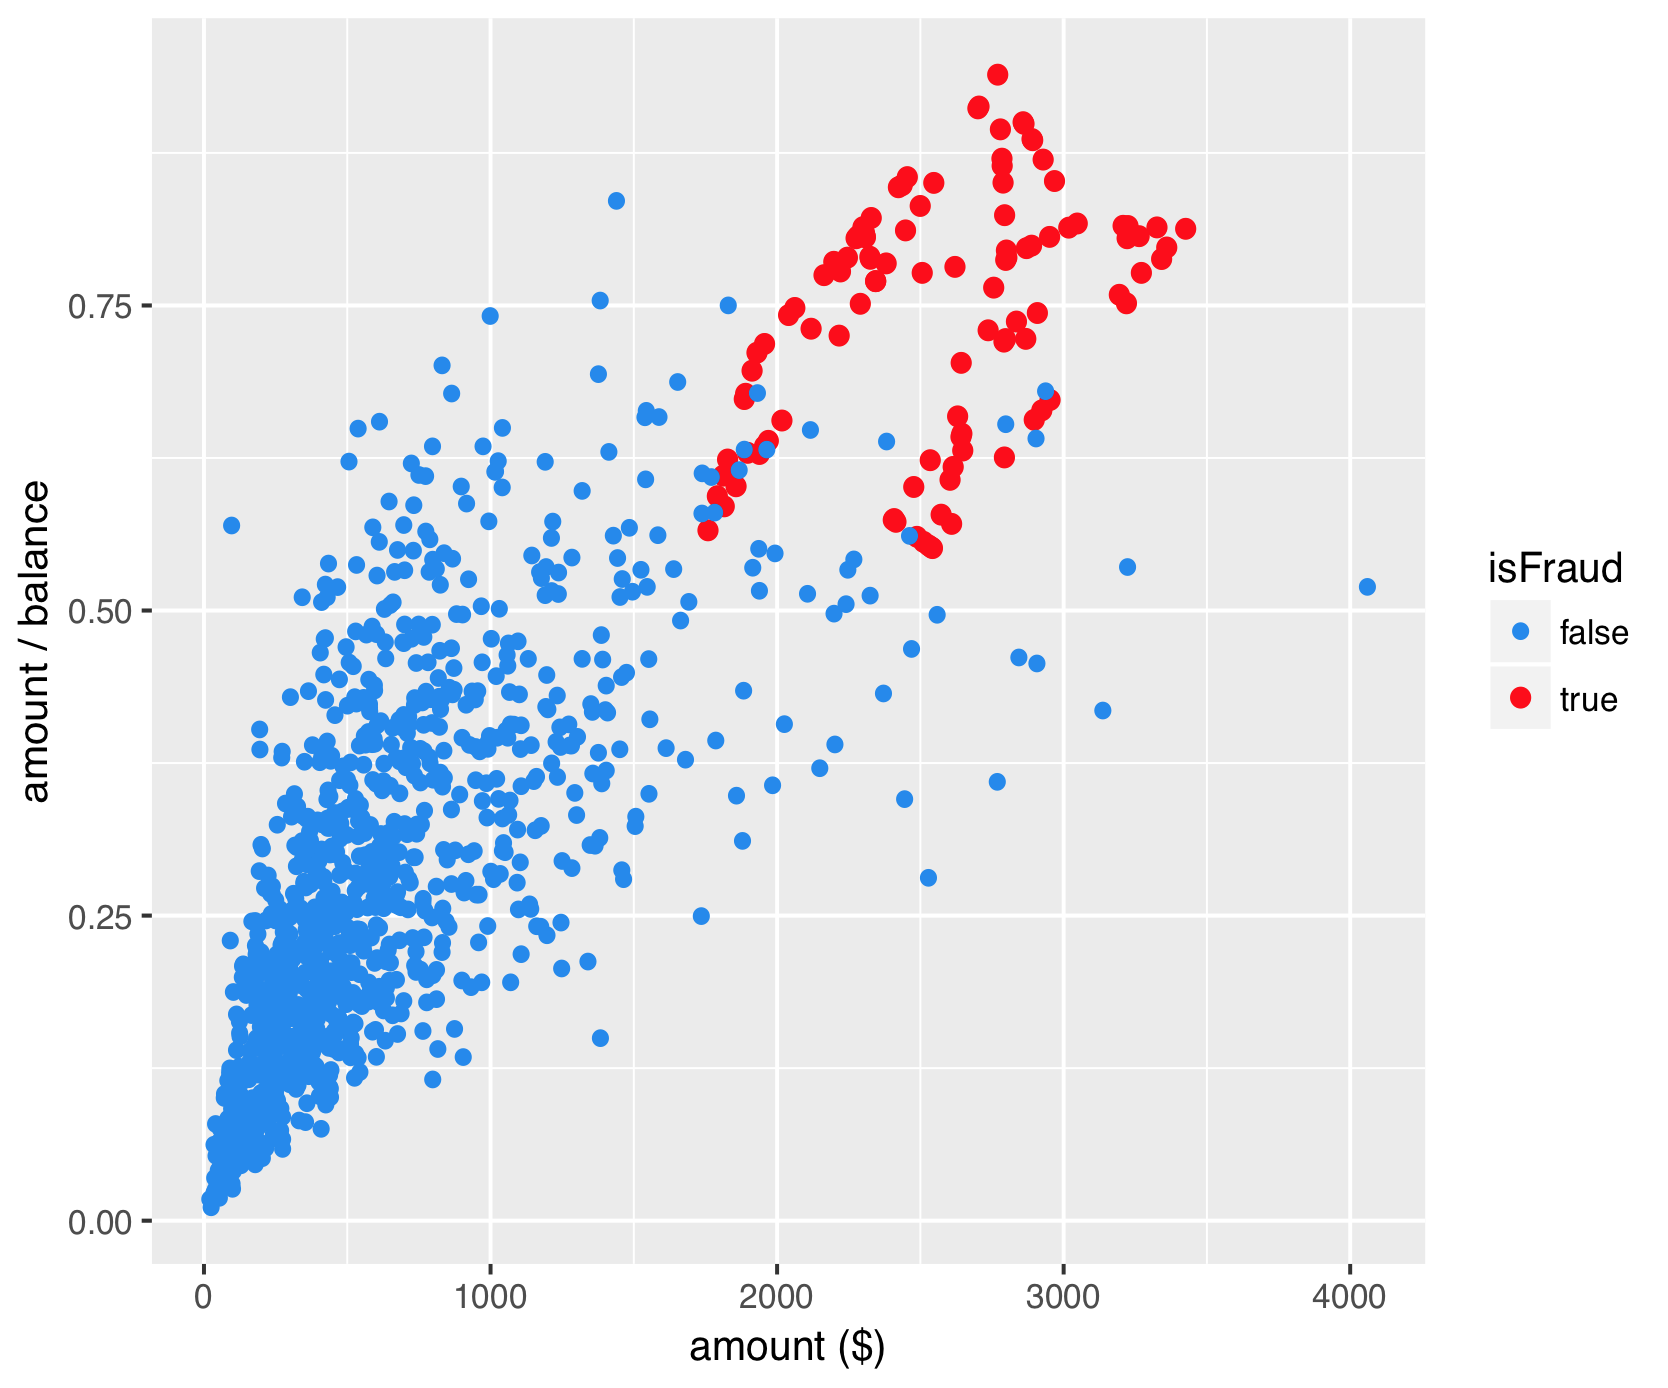
table(oversampled_data$isFraud)
false  true
  990   110
prop.table(table(oversampled_data$isFraud))
false  true
  0.9   0.1
R 的詐欺偵測

smote_result

R 的詐欺偵測

一起來練習吧!

R 的詐欺偵測

Preparing Video For Download...