時間特徵

R 的詐欺偵測

Bart Baesens

Professor Data Science at KU Leuven

時間分析

  • 許多事件會在相近的時間點發生
  • 例:同一客戶常在相近時段交易
  • 目標:用有意義的特徵擷取時間面向的資訊
  • 處理時間不太直觀
    • 00:00 = 24:00
    • 沒有自然的排序,例如 23:00 $<$ 或 $>$ 01:00?
R 的詐欺偵測
  • 不要用算術平均來計算時間戳的平均!
    • 例:交易發生在 01:00、02:00、21:00、22:00
    • 算術平均是 11:30,但實際上沒有接近該時刻的交易!
head(timestamps)
"20:27:28" "21:08:41" "01:30:16" "00:57:04" "23:12:14" "22:54:16"
  • 將數位時間戳轉為小時的十進位格式
library(lubridate)
ts <- as.numeric(hms(timestamps)) / 3600

head(ts)
20.4577778 21.1447222  1.5044444  0.9511111 23.2038889 22.9044444
R 的詐欺偵測

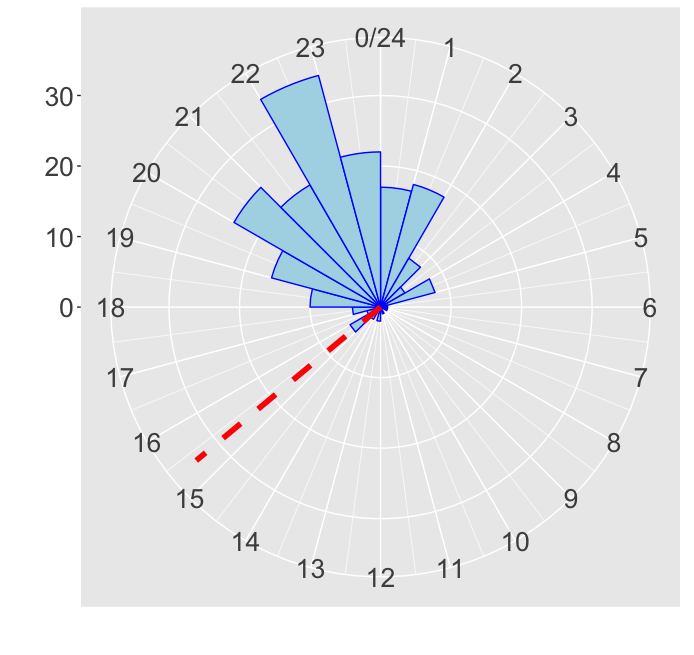
環狀長條圖

library(ggplot2)

clock <- ggplot(data.frame(ts), aes(x = ts)) +
    geom_histogram(breaks = seq(0, 24), colour = "blue", fill = "lightblue") +
    coord_polar()


arithmetic_mean <- mean(ts) clock + geom_vline(xintercept = arithmetic_mean, linetype = 2, color = "red", size = 2)
R 的詐欺偵測

含算術平均的環狀長條圖

wrong_clock

R 的詐欺偵測

von Mises 機率分佈

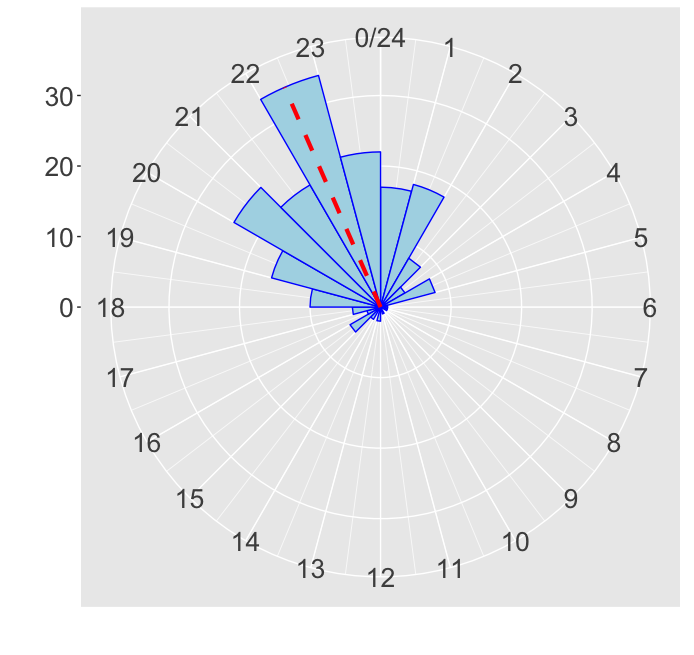
  • 將時間視為週期變數,使用 von Mises 分佈(Correa Bahnsen 等,2016)
  • 週期常態分佈=把常態分佈繞成一個圓
  • 一組時間戳的 von Mises 分佈 $D= $ {$t_1, t_2, \ldots, t_n$}

$$D\sim vonMises\left(\mu,\kappa\right)$$

  • $\mu$:週期平均、位置量度,分佈聚集在 $\mu$ 附近
  • $1/\kappa$:週期變異;$\kappa$ 為集中程度
R 的詐欺偵測

估計參數 $\mu$ 與 $\kappa$

# Convert the decimal timestamps to class "circular"
library(circular)
ts <- circular(ts, units = "hours", template = "clock24")

head(ts)
Circular Data: 
[1] 20.457889 21.144607  1.504422  0.950982 23.203917  4.904397
estimates <- mle.vonmises(ts)
p_mean <- estimates$mu %% 24
concentration <- estimates$kappa
R 的詐欺偵測

含週期平均的環狀長條圖

correct_clock

R 的詐欺偵測

信賴區間

  • 萃取新特徵:交易時間的信賴區間
  • $S= $ {$x_i^{time}|i=1,\ldots,n$}:同一客戶的交易集合

(1) 以 mle.vonmises() 依據 $S$ 估計 $\mu(S)$ 與 $\kappa(S)$:

estimates <- mle.vonmises(ts)
p_mean <- estimates$mu %% 24
concentration <- estimates$kappa

(2) 用 dvonmises() 計算時間戳的機率密度(= 對數值的相對可能性):

densities <- dvonmises(ts, mu = p_mean, kappa = concentration)
R 的詐欺偵測

特徵萃取

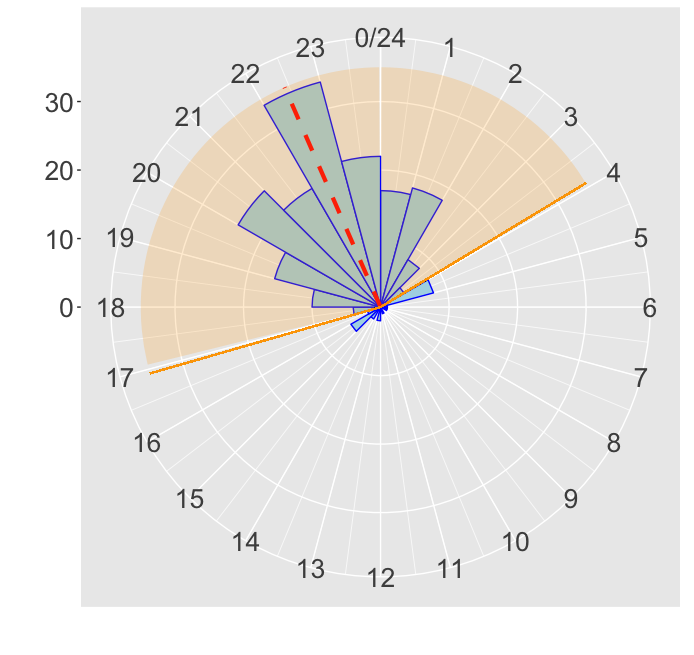
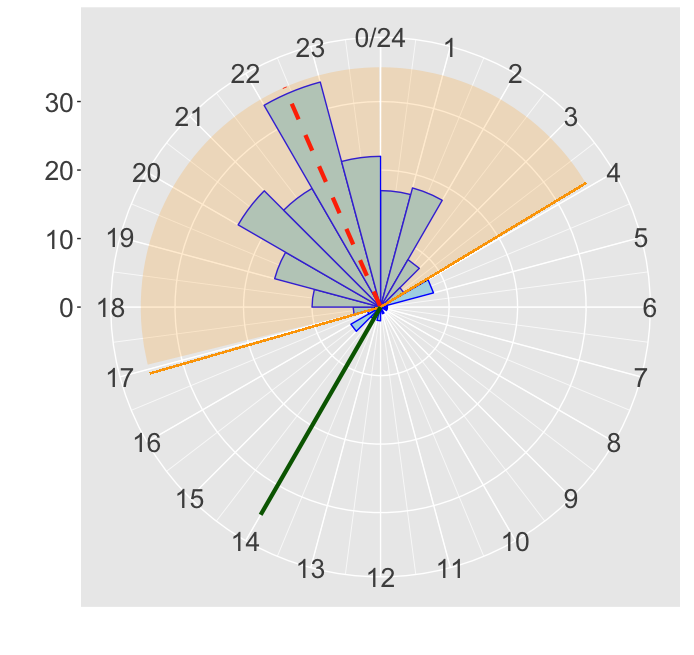
  • 二元特徵:新交易的時間戳落在信賴區間(CI)內的機率為 $\alpha$(如 0.90、0.95),否則不在
  • 若時間戳在 CI 內,二元時間特徵為 TRUE,否則為 FALSE
  • 若其密度大於臨界值,則屬於 90% CI:
alpha <- 0.90
quantile <- qvonmises(p = (1 - alpha)/2, 
                        mu = p_mean,
                        kappa = concentration) %% 24
cutoff <- dvonmises(quantile,
                      mu = p_mean, kappa = concentration)

time_feature <- densities >= cutoff
R 的詐欺偵測

信賴區間

confidence_clock

R 的詐欺偵測

信賴區間

confidence_clock_2

R 的詐欺偵測

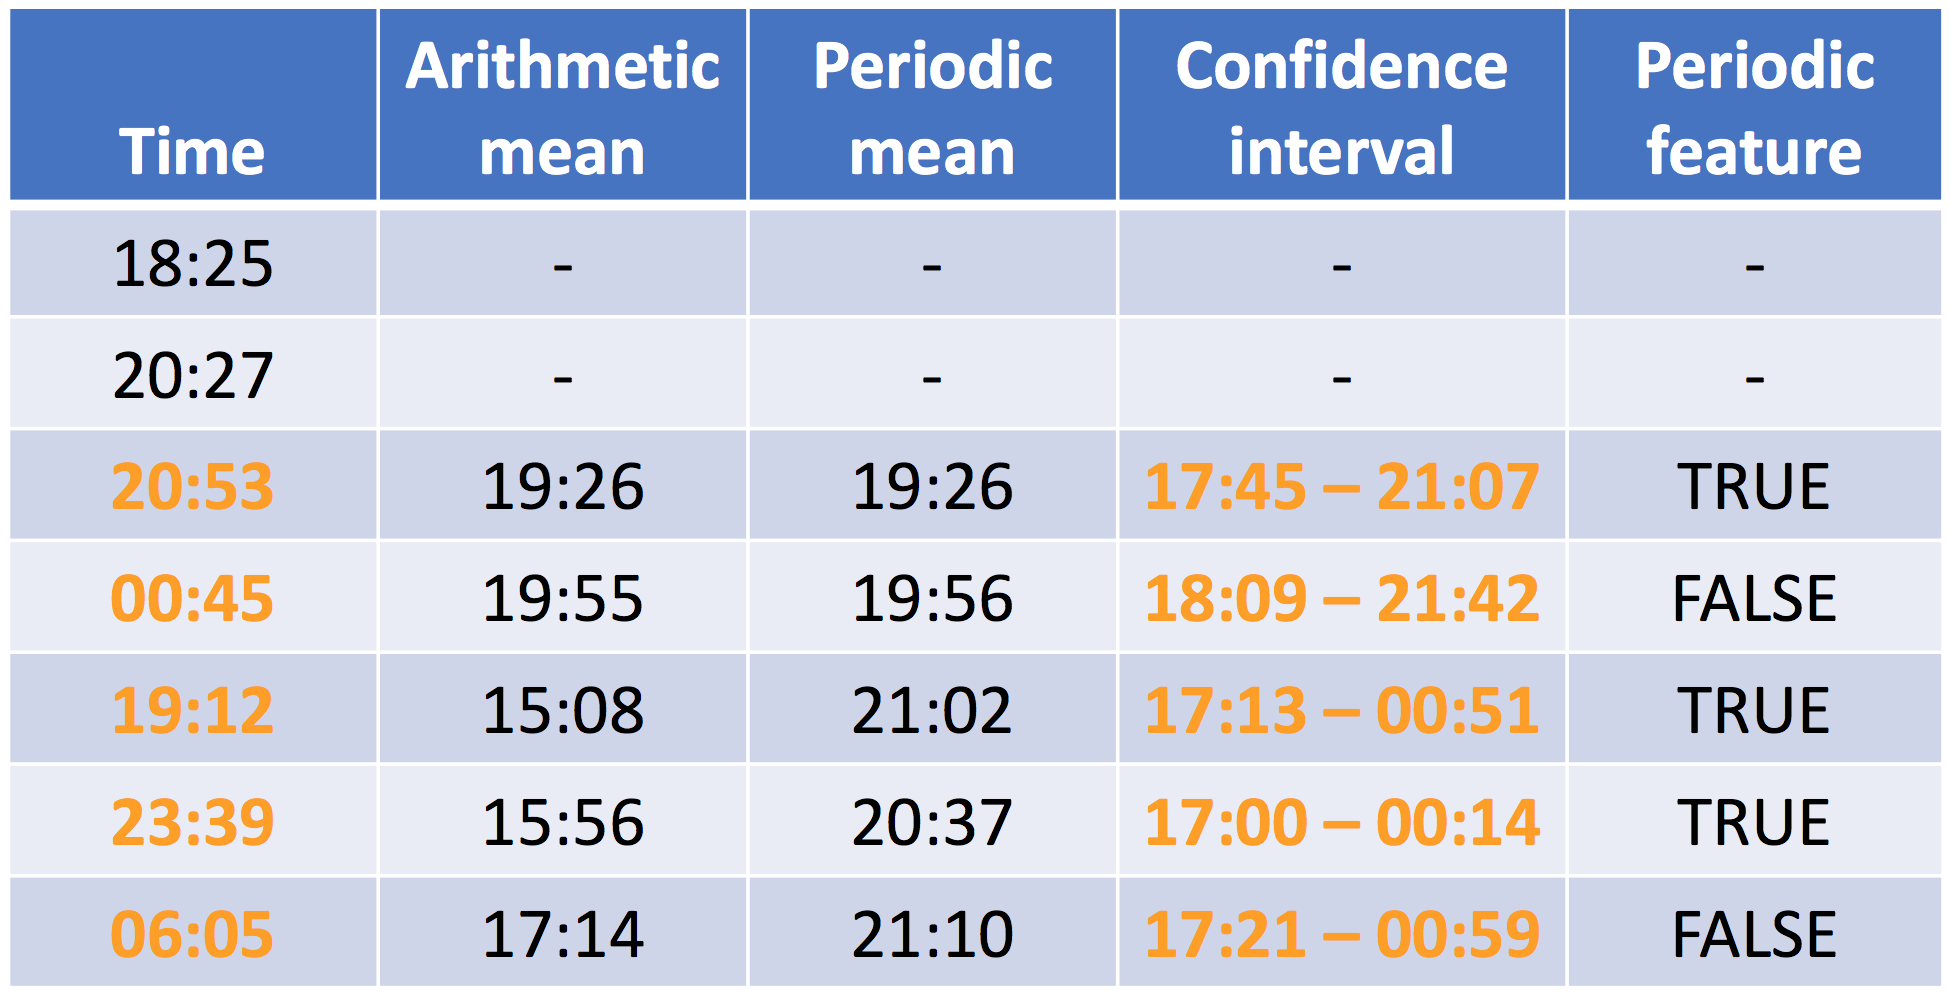
範例

$$ $$ time_table

R 的詐欺偵測

移動時間窗的信賴區間

## ts contains the timestamps 18.42, 20.45, 20.88, 0.75, 19.20, 23.65 and 6.08

time_feature = c(NA, NA) for (i in 3:length(ts)) { ts_history <- ts[1:(i-1)] ## (1) Previous timestamps
estimates <- mle.vonmises(ts_history) ## (2) Estimate mu and kappa on historic timestamps p_mean <- estimates$mu %% 24 concentration <- estimates$kappa
dens_i <- dvonmises(ts[i], mu = p_mean, kappa = concentration) ## (3) Estimate density of current timestamp
alpha <- 0.90 ## (4) Check if density is larger than cutoff with confidence level 90% quantile <- qvonmises((1-alpha)/2, mu=p_mean, kappa=concentration) %% 24 cutoff <- dvonmises(quantile, mu = p_mean, kappa = concentration) time_feature[i] <- dens_i >= cutoff }
print(time_feature)
NA    NA  TRUE FALSE  TRUE  TRUE FALSE
R 的詐欺偵測

一起來練習吧!

R 的詐欺偵測

Preparing Video For Download...