監控與管理記憶體

R 平行程式設計

Nabeel Imam

Data Scientist

佇列與空間
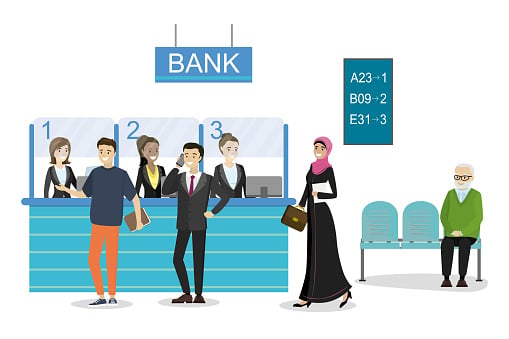
三位櫃員為銀行顧客服務,其他顧客在排隊等候。

R 平行程式設計

平行流程

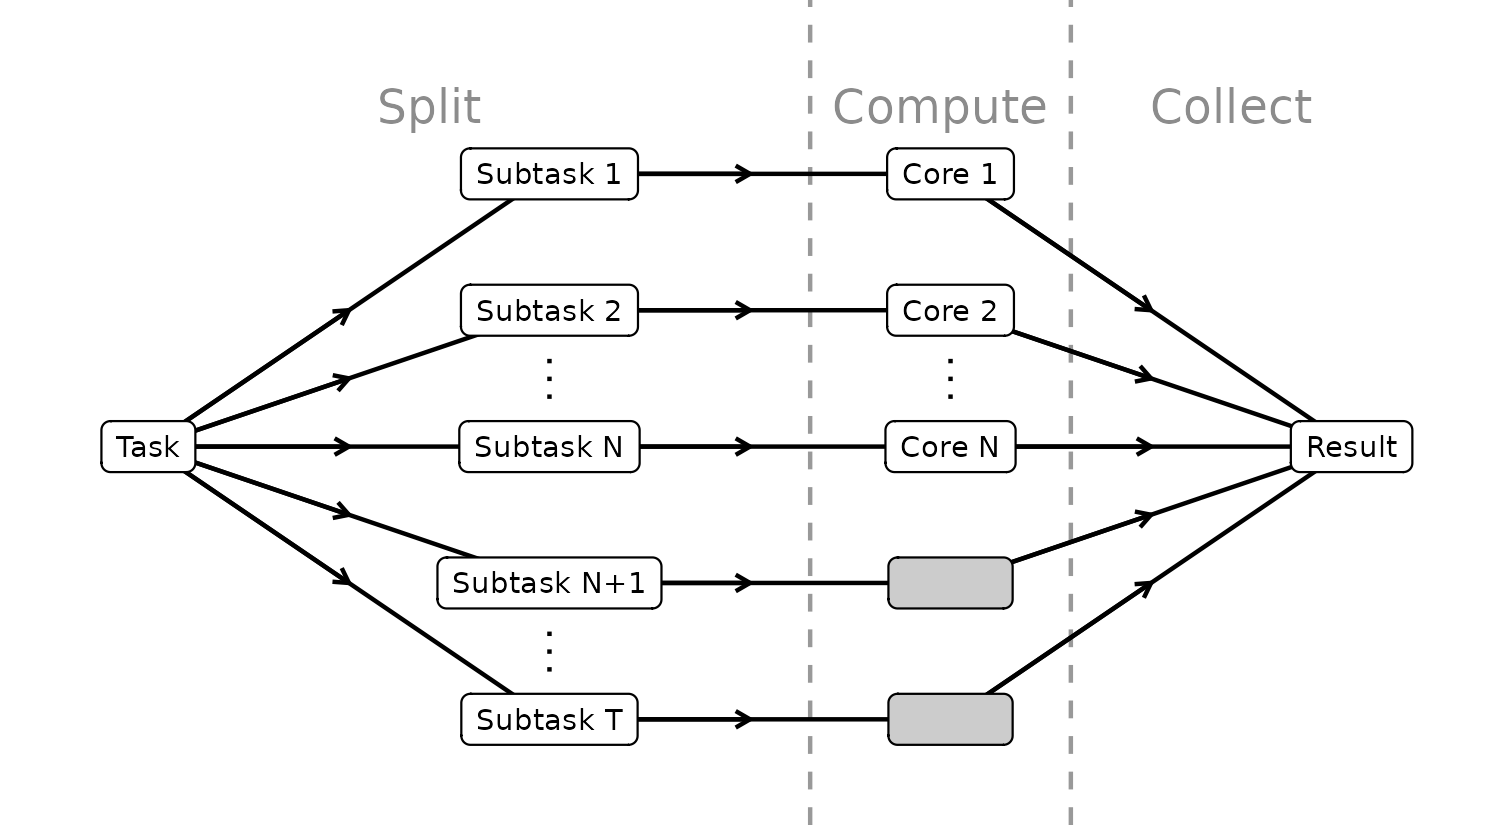
示意平行流程:將任務切成多個小子任務,由不同核心執行後再彙整結果。

R 平行程式設計

平行流程

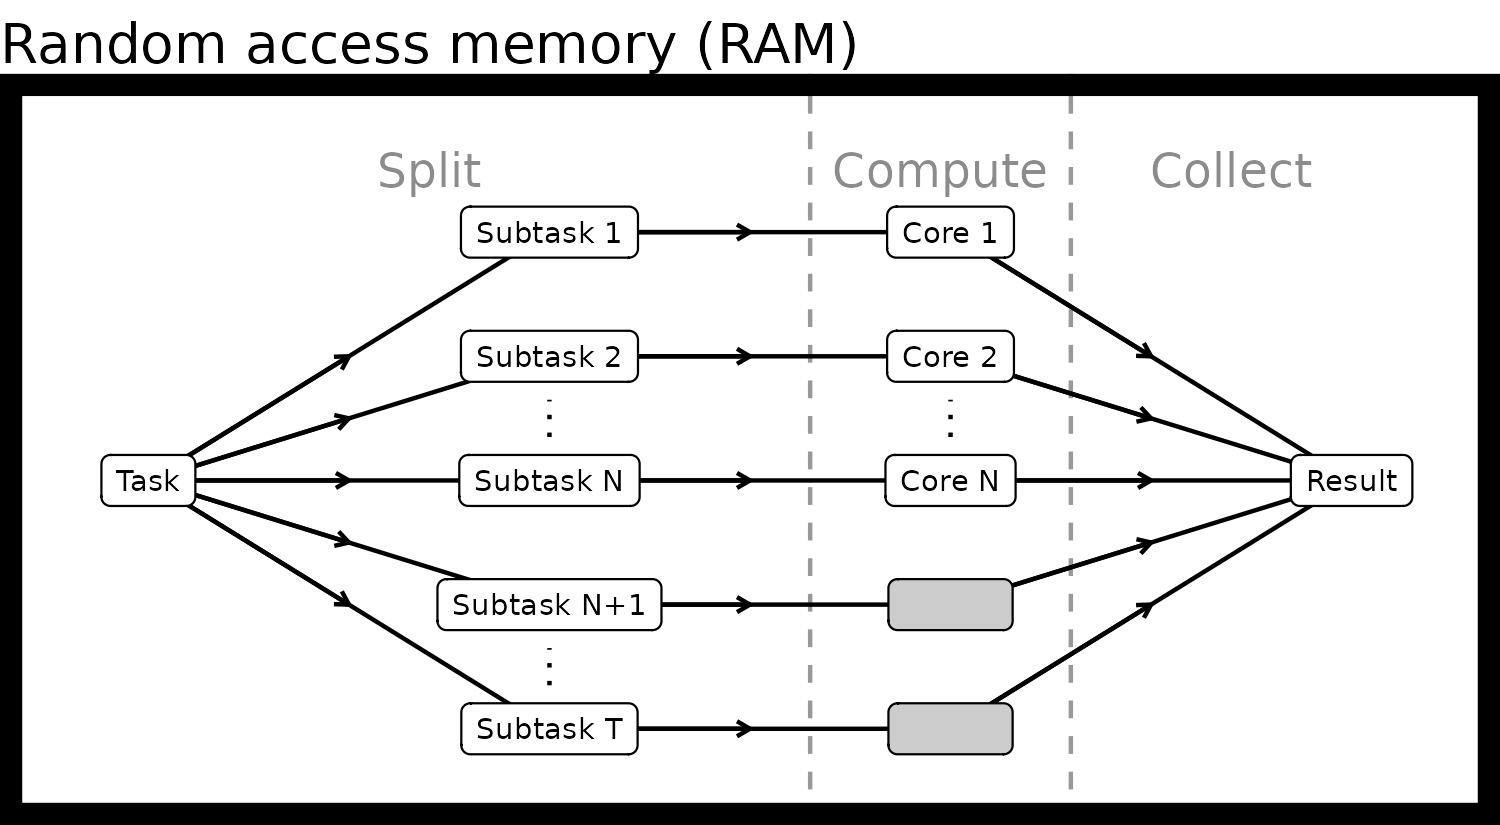
平行流程運作於隨機存取記憶體(RAM)中。

R 平行程式設計

出生資料

print(ls_files)
 [1] "./births/AK.csv"
 [2] "./births/AL.csv"
 [3] "./births/AR.csv"
 [4] "./births/AZ.csv"
 [5] "./births/CA.csv"
 [6] "./births/CO.csv"
 [7] "./births/CT.csv"
 [8] "./births/DC.csv"
 [9] "./births/DE.csv"
 [10] "./births/FL.csv"
...
R 平行程式設計

以 futures 映射

plan(multisession, workers = 2)

ls_df <- future_map(ls_files, read.csv)
plan(sequential)
print(ls_df)
[[1]]
   state month plurality weight_gain_pounds mother_age
      AK     1         1                 30         43
   ...
[[2]]
   state month plurality weight_gain_pounds mother_age
      AL    10         1                 60         33
   ...
...
R 平行程式設計

兩個 workers 的分析

profvis({
  plan(multisession, workers = 2)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

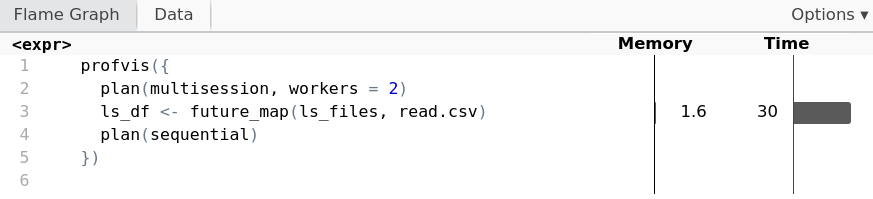
由 profvis 產生的程式分析輸出。使用兩個 workers 搭配 future_map 平行讀取 CSV 佔用 1.6 MB 記憶體,其餘程式行未顯示使用量。

R 平行程式設計

四個 workers 的分析

profvis({
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

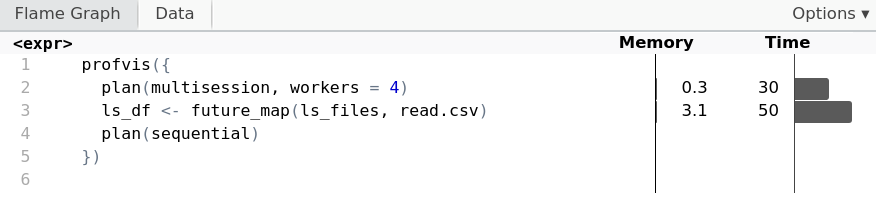
由 profvis 產生的程式分析輸出。使用四個 workers 搭配 future_map 平行讀取 CSV 佔用 3.1 MB 記憶體,而規劃 multisession 佔用 0.3 MB。

R 平行程式設計

幕後運作

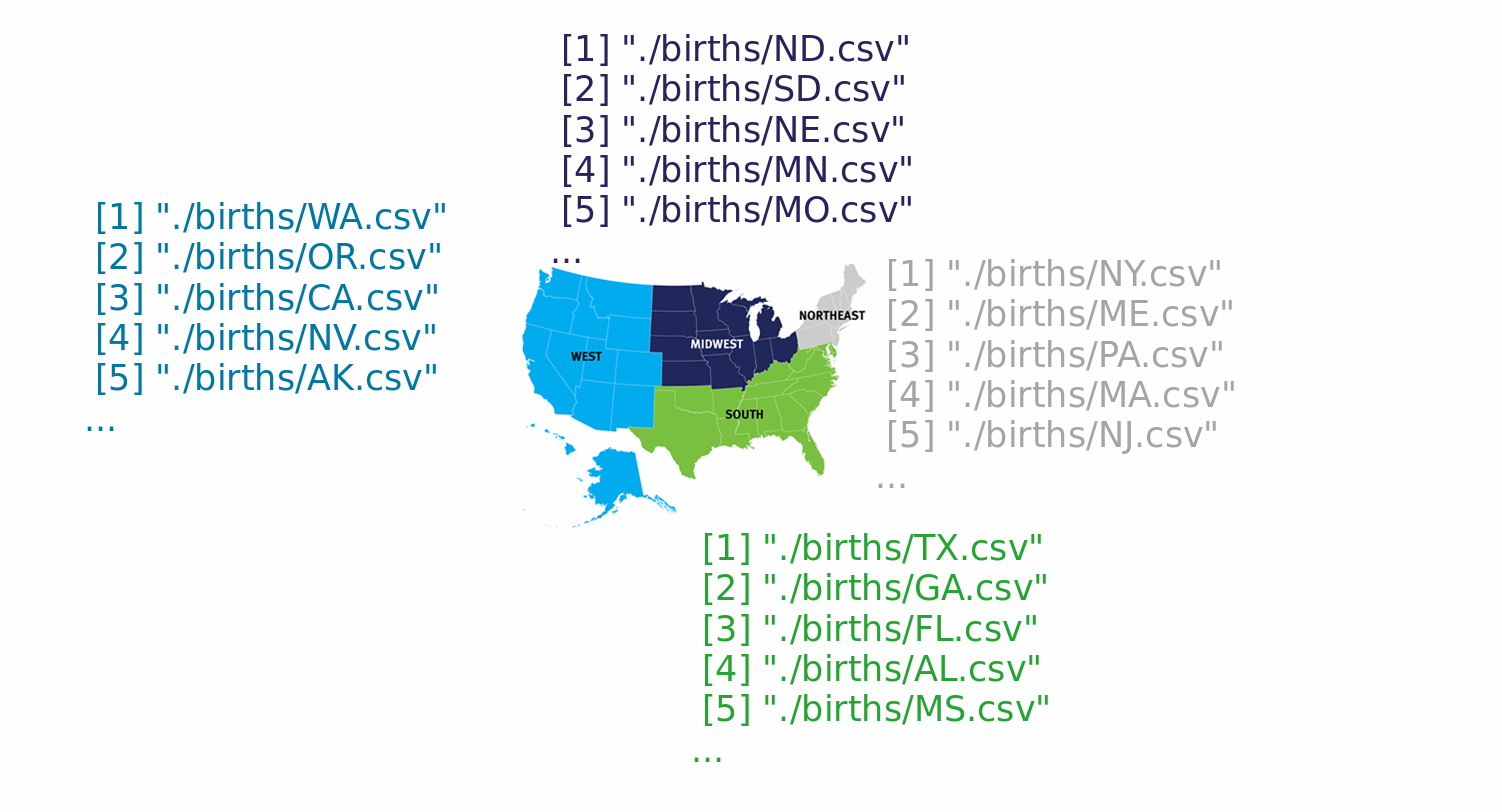
美國地圖,劃分為西部、中西部、南部、東北部四區;每區對應一份各州 CSV 檔名清單。

R 平行程式設計

以分塊管理記憶體

config <- furrr_options(chunk_size = 26)

plan(multisession, workers = 4) ls_df <- future_map(ls_files, read.csv,
.options = config) plan(sequential)
R 平行程式設計

以分塊管理記憶體

profvis({
  config <- furrr_options(chunk_size = 26)
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv,
             .options = config)
  plan(sequential)
})

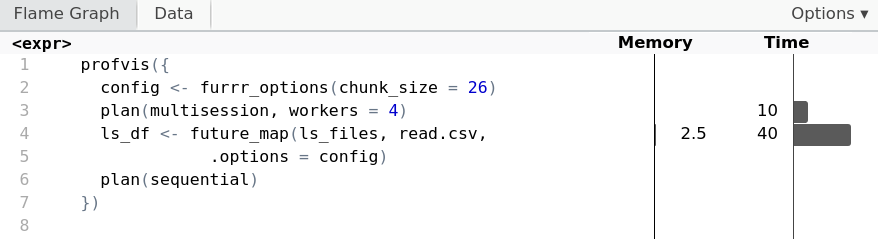
由 profvis 產生的程式分析輸出。以四個 workers 搭配 future_map 並將 chunk_size 設為 26 時,平行讀取 CSV 佔用 2.5 MB 記憶體。

R 平行程式設計

parallel 的分塊

cl <- makeCluster(4)


ls_df <- parLapply(cl, ls_files, read.csv)
stopCluster(cl)

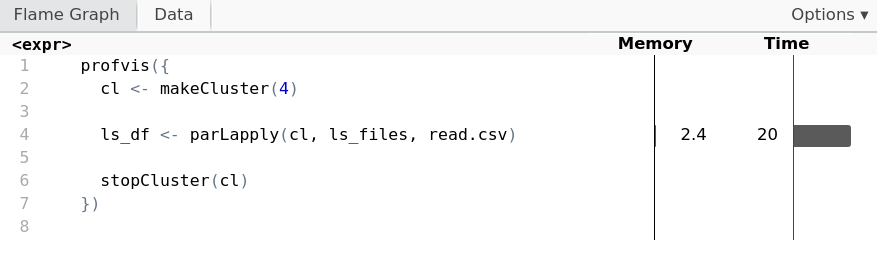
使用 parLapply 平行讀取 CSV 時佔用 2.4 MB 記憶體,主要集中在 parLapply 呼叫。

R 平行程式設計

parallel 的分塊

cl <- makeCluster(4)
ls_df <- parLapply(cl, ls_files, read.csv,

chunk.size = 26)
stopCluster(cl)

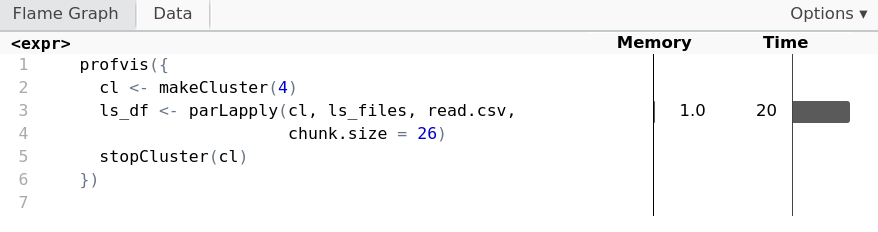
將 chunk.size 設為 26 時,使用 parLapply 平行讀取 CSV 僅佔用 1 MB 記憶體。

R 平行程式設計

何時要分塊?

  • 預設已最佳化分塊
  • 當資料物件很大且記憶體吃緊時
    • 若可行,嘗試減少核心數
    • 嘗試不同分塊大小以找到最佳值
R 平行程式設計

一起來練習吧!

R 平行程式設計

Preparing Video For Download...