依遺漏值篩選

R 的降維

Matt Pickard

Owner, Pickard Predictives, LLC

計算遺漏值比率
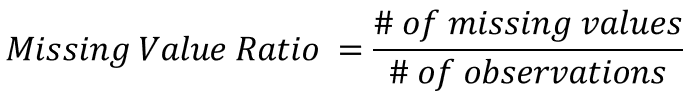
遺漏值比率公式

n <- nrow(credit_df)


missing_vals_df <- credit_df %>% summarize(across(everything(), ~ sum(is.na(.)))) %>%
pivot_longer(everything(), names_to = "feature", values_to = "num_missing_values") %>%
mutate(missing_val_ratio = num_missing_values / n)
R 的降維

遺漏值比率輸出

missing_vals_df
# A tibble: 5 × 3
  feature          num_missing_values missing_val_ratio
  <chr>                         <int>             <dbl>
1 credit_score                      0             0    
2 annual_income                     0             0    
3 age                              84             0.613
4 outstanding_debt                129             0.942
5 num_of_loan                       0             0  
R 的降維

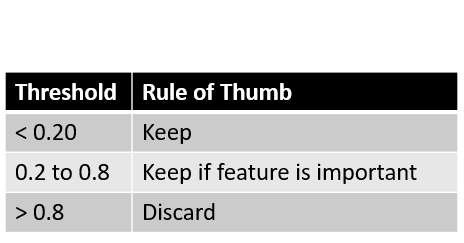
遺漏值比率門檻的經驗法則

  • 沒有客觀門檻
  • 取決於特徵重要性
    • 例如:outstanding_debtage

遺漏值比率門檻的經驗法則表

R 的降維

建立遺漏值篩選器

missing_vals_filter <- missing_vals_df %>% 
  filter(missing_val_ratio <= 0.5) %>%

pull(feature)
missing_vals_filter
[1] "credit_score"  "annual_income" "num_of_loan"
R 的降維

套用遺漏值篩選器

filtered_credit_df <- credit_df %>% 
  select(missing_vals_filter)

filtered_credit_df %>% head(3)
# A tibble: 5 × 3
  credit_score annual_income num_of_loan
  <chr>                <dbl>       <dbl>
1 Standard            87630.           4
2 Standard            16574.           7
3 Standard            24931.           2
R 的降維

tidymodels 作法

建立 recipe

missing_vals_recipe <- 
  recipe(credit_score ~ ., data = credit_df) %>%

step_filter_missing(all_predictors(), threshold = 0.5) %>%
prep()

套用 recipe

filtered_credit_df <- 
  bake(missing_vals_recipe, new_data = NULL)
R 的降維

烘焙後的輸出

filtered_credit_df %>% head(5)
# A tibble: 5 × 3
  annual_income num_of_loan credit_score
          <dbl>       <dbl> <fct>       
1        87630.           4 Standard    
2        16574.           7 Standard    
3        24931.           2 Standard    
4       136680.           1 Good        
5        76850.           3 Standard 
R 的降維

一起來練習吧!

R 的降維

Preparing Video For Download...