用 Python 透過機器學習預測 CTR
Kevin Huo
Instructor
print(df.hour.head(1))
14102101
df['hour'] = pd.to_datetime(
  df['hour'], format = '%y%m%d%H')
df['hour_of_day'] = df['hour'].dt.hour
print(df.hour.head(1))
2014-10-21 01:00:0
print(df.groupby('hour_of_day')
      ['click'].sum())
             click
hour_of_day
1             1092
2             6546
類別特徵必須轉成數值格式。
雜湊函式:將任意輸入對映成整數輸出,對同一輸入會回傳完全相同的輸出。
Lambda 函式:lambda x: f(x)。
lambda x: f(x)
透過 f(x) = hash(x) 套用雜湊函式:
f(x) = hash(x)
df['site_id'] = df['site_id'].apply(lambda x: hash(x))
83a0ad1a -> -9161053084583616050
85f751fd-> 818242008494177460
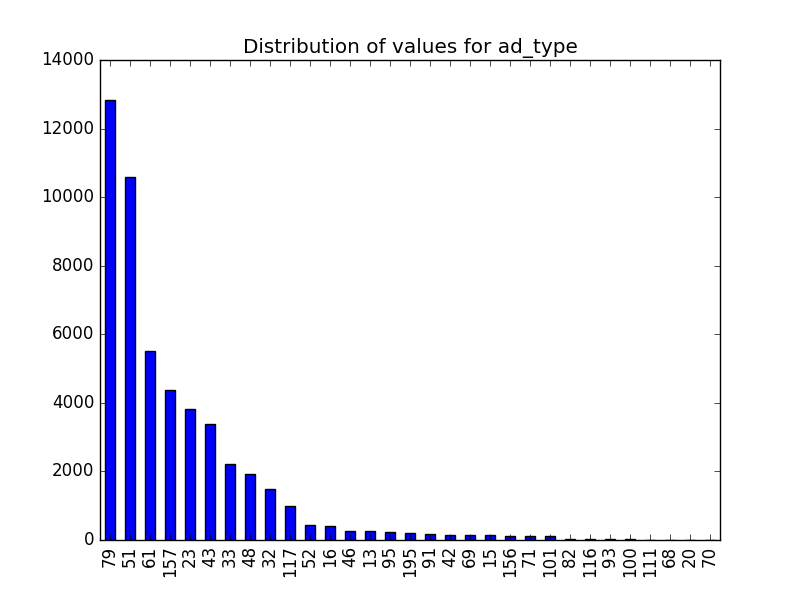
count()
nunique()
df['ad_type'].count()
50000
df['ad_type'].nunique()
31
增加特徵通常能提升預測力。
新特徵範例:依 device_id(使用者)與 search_engine_type 的曝光數:
device_id
search_engine_type
df['device_id_count'] = df.groupby('device_id')['click'].transform("count")
df['search_engine_type_count'] = df.groupby('search_engine_type')['click'].transform("count")
print(df.head(1))
...  device_id_count  search_engine_type_count
...            40862                     47710