用 Python 透過機器學習預測 CTR
Kevin Huo
Instructor
site_id
app_id
device_id
df.var()
click                   1.294270e-01
hour                    1.123316e-01
df.var().median()
0.7108583771671939
print(df['click'].var())
df['device_id_count'] = df[
  'device_id_count'].apply(
  lambda x: np.log(x))
print(df['click'].var())
249362570.10134825
15.628476003312514
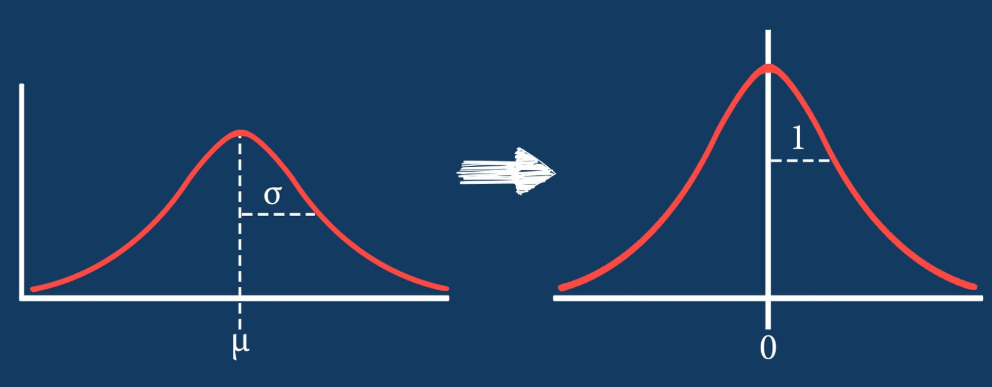
StandardScaler()
scaler = StandardScaler()
X[numeric_cols] = scaler.fit_transform(X[numeric_cols])
dtype: float64
1    10.5 -> 0.85
2    32.3 -> 1.54